Федеральний реєстр США використовує китайську модель Qwen
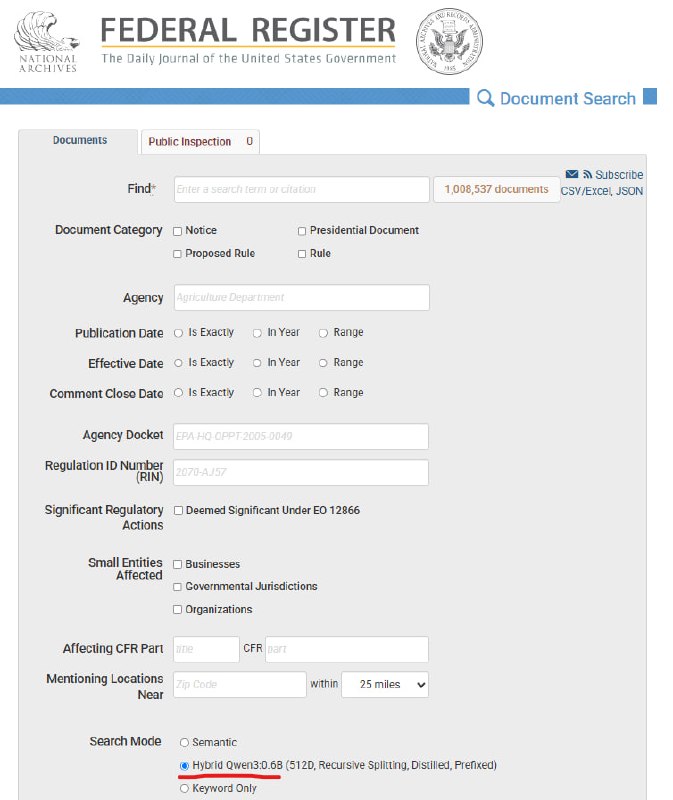
Федеральний реєстр США використовує дистильовану версію китайської моделі Qwen для пошуку за державними документами.
У налаштуваннях прямо вказано Hybrid Qwen3:0.6B Distilled.
Особливо іронічно це виглядає на тлі звинувачень Китаю в «дистилляції моделей у промислових масштабах».
Чому це важливо
АналітикаЦе підкреслює глобальну залежність західних інституцій від китайських відкритих моделей та показує абсурдність політичних звинувачень у крадіжці технологій.
Обговорити новину у спільноті
Діліться своїм досвідом та думками з ШІ-розробниками
Пов'язані матеріали екосистеми
Практичні гайди, термінологія та агентські скіли
Дослідники MIT CSAIL показали Weight-Space Programming: ШІ без навчання редагує ваги Qwen3.5-0.8B
Розробники з MIT CSAIL описали Weight-Space Programming: модель Astra без градієнтного спуску читала ваги Qwen3.5-0.8B і покращила її результати на математичних бенчмарках.
JSON — структуровані дані для програм, API та AI-агентів
Повний практичний посібник з формату JSON: синтаксичні правила, серіалізація через parse/stringify, робота з REST API, JSON Schema та структурований вивід для штучного інтелекту.
Формати DOCX та XLSX: коли потрібен повноцінний фінальний документ від ШІ
Повний практичний посібник з генерації та опрацювання документів DOCX і таблиць XLSX за допомогою ШІ: порівняння з Markdown та CSV, промпт-інжиніринг, робота з формулами та автоматизація в коді.
Context Distillation & Token Squeezing
Методи автоматичного видалення надлишкових слів, синтаксичного шуму, форматувальних пробілів та застарілих повідомлень перед відправкою промпту в модель для економії бюджету та прискорення інференсу.