US Federal Register nutzt chinesisches Qwen-Modell für Dokumentensuche
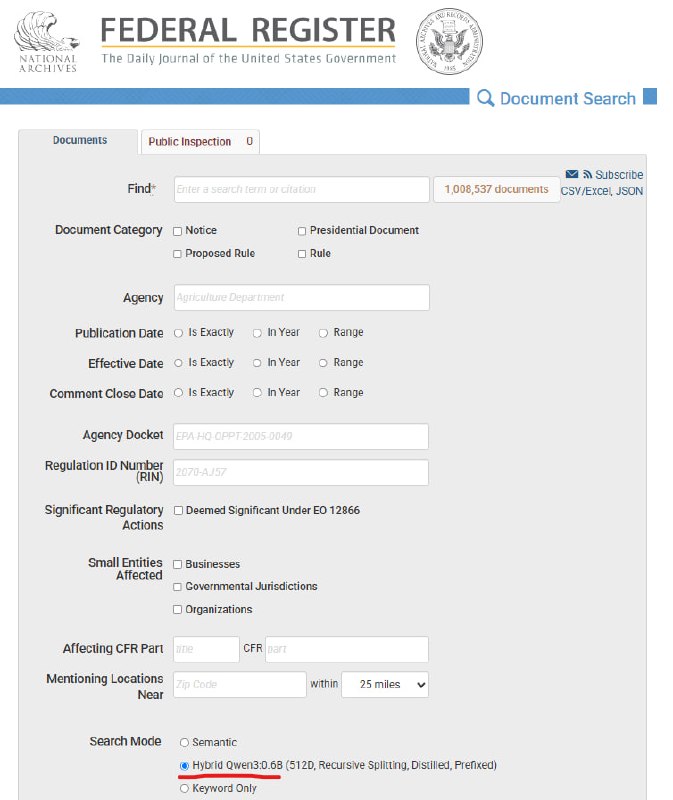
Der US Federal Register setzt eine destillierte Version des chinesischen Qwen-Modells zur Durchsuchung von Regierungsdokumenten ein. Dies steht in bemerkenswertem Widerspruch zu den aktuellen Vorwürfen der USA gegen China bezüglich großflächiger Modell-Destillation.
Der US Federal Register verwendet eine destillierte Version des chinesischen Modells Qwen, um Regierungsdatenbanken zu durchsuchen.
Die technischen Einstellungen im System geben explizit Hybrid Qwen3:0.6B Distilled an.
Diese Konfiguration wirkt vor dem Hintergrund der jüngsten Anschuldigungen seitens der US-Regierung besonders ironisch, die China beschuldigen, "industrielle Maßstäbe" bei der Destillation von KI-Modellen zu erreichen und geistiges Eigentum zu verletzen.
Warum das wichtig ist
AnalyseDieser Fall unterstreicht die globale Abhängigkeit von chinesischen Open-Source-KI-Modellen und hebt die Widersprüche in den geopolitischen Spannungen rund um den Vorwurf des technologischen Diebstahls hervor.
In der Community diskutieren
Teile deine Fragen und Erkenntnisse mit Entwicklern
Verwandt im Ökosystem
Praktische Leitfäden, Terminologie und Agenten-Skills
Modell-Distillation & Reasoning-Transfer
Methodik zur Übertragung von Wissen und Reasoning-Ketten von einem großen Teacher Model auf ein kompaktes Student Model für schnelle und kostengünstige Inferenz.
MIT-Forscher zeigen: LLM kann Gewichte von Modellen ohne Training lesen und verändern
MIT CSAIL stellte Weight-Space Programming vor: Astra las und änderte Gewichte von Qwen3.5-0.8B ohne Gradientenabstieg oder Feinabstimmung und verbesserte die Mathematik-Benchmarks.
MIT-Forschende zeigen, dass GPT-6 Astra andere KI-Modelle durch direkte Gewichtsänderungen verbessern kann
In einem Experiment erhöhte Astra die Genauigkeit von Qwen3.5-0.8B auf MATH-500 von 7,9 % auf 48,1 %, indem nur 0,016 % der Modellgewichte geändert wurden.
JSON – strukturierte Daten für Anwendungen, APIs und KI-Agenten
Ein umfassender praktischer Leitfaden zum JSON-Format: Syntaxregeln, Serialisierung über parse/stringify, Arbeit mit REST-APIs, JSON Schema und strukturierter Output für künstliche Intelligenz.