Federal Register USA wykorzystuje chiński model Qwen do przeszukiwania dokumentów
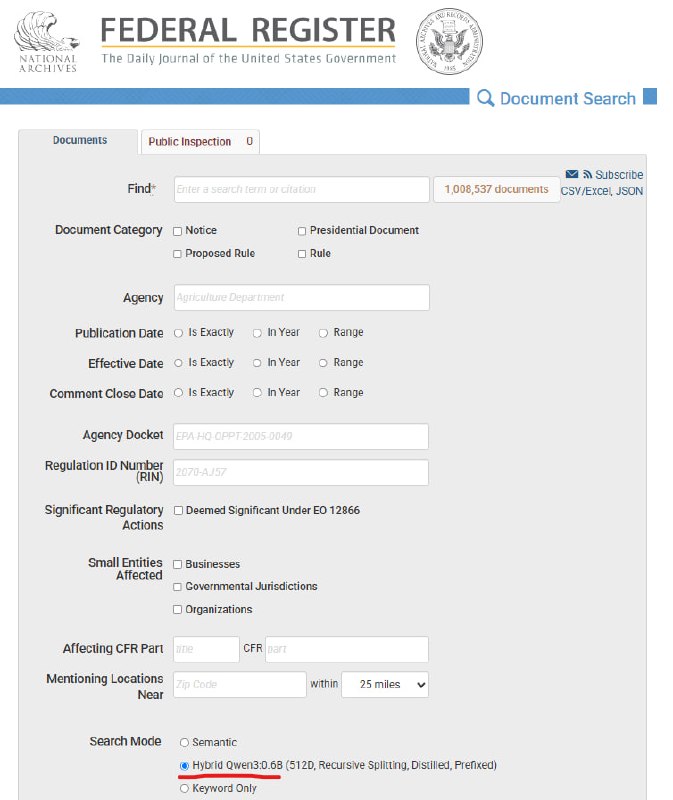
Amerykański Federal Register opiera się na skondensowanej wersji chińskiego modelu Qwen, co tworzy ironiczny kontrast wobec oskarżeń kierowanych pod adresem Chin.
The US Federal Register is using a distilled version of the Chinese model Qwen to search through government documents.
The settings explicitly state Hybrid Qwen3:0.6B Distilled.
This looks particularly ironic against the backdrop of accusations against China for "industrial-scale model distillation."
Dlaczego to ważne
AnalizaSytuacja ta podkreśla globalną zależność od chińskich modeli AI open-source oraz uwypukla paradoks napięć geopolitycznych dotyczących rzekomego kradzieży technologii sztucznej inteligencji.
Dyskutuj w społeczności
Dziel się swoimi pytaniami i spostrzeżeniami z programistami
Powiązane w ekosystemie
Praktyczne poradniki, kluczowa terminologia i skille agentów
Model Distillation & Reasoning Transfer
Methodology for transferring knowledge and reasoning chains from a giant teacher model to a compact student model, enabling fast and cost-effective inference.
Badacze z MIT pokazali, że LLM może czytać i edytować wagi modeli bez uczenia
MIT CSAIL zaprezentował Weight-Space Programming: Astra czytała i modyfikowała wagi Qwen3.5-0.8B bez gradientowego spadku i fine-tuningu, poprawiając wyniki w benchmarkach matematycznych.
Badacze z MIT pokazali, że GPT-6 Astra może ulepszać inne modele AI przez bezpośrednią zmianę wag
W eksperymencie Astra zwiększyła dokładność Qwen3.5-0.8B w benchmarku MATH-500 z 7,9% do 48,1%, zmieniając zaledwie 0,016% wag modelu.
JSON — dane ustrukturyzowane dla aplikacji, API i agentów AI
Kompletny praktyczny przewodnik po formacie JSON: zasady składniowe, serializacja za pomocą parse/stringify, praca z REST API, JSON Schema oraz strukturalne wyjście dla sztucznej inteligencji.