Kimi K3.1 et DeepSeek V4.1 Flash auraient été distillés à partir d’Astra
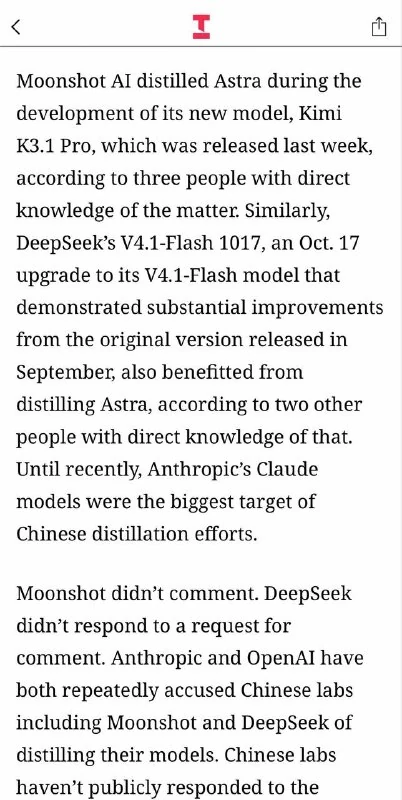
The Information affirme que Kimi K3.1 et DeepSeek V4.1 Flash pourraient avoir été créés par distillation à partir d’Astra, un modèle associé à OpenAI.
The Information rapporte que Kimi K3.1, un modèle chinois récemment publié, aurait été distillé à partir d’Astra, un modèle associé à OpenAI.
La même publication affirme qu’une approche similaire pourrait avoir été utilisée pour le nouveau checkpoint DeepSeek V4.1 Flash.
Pourquoi c’est important
- La distillation d’un modèle d’IA consiste à entraîner un modèle plus petit à partir des sorties ou des états cachés d’un modèle plus large.
- Si ces affirmations se confirment, Astra pourrait être une source clé de connaissances pour les laboratoires chinois d’IA.
- Ce cas illustre la rapidité avec laquelle les capacités peuvent circuler entre les grands écosystèmes d’IA.
Pourquoi c'est important
AnalyseSi ces affirmations se confirment, cela montre comment la distillation peut accélérer le transfert de capacités entre écosystèmes d’IA majeurs et relance les débats sur l’origine des modèles.
Discuter dans la communauté
Partagez vos questions et vos idées avec les développeurs
Lié dans l'écosystème
Guides pratiques, terminologie clé et compétences d'agents
DeepSeek V4.1 Flash est désormais disponible dans Cursor
DeepSeek V4.1 Flash est désormais disponible dans Cursor ; d’après les résultats de CursorBench, une tâche coûte entre 0,60 $ et 0,98 $, ce qui rend le modèle attractif pour le travail quotidien avec le code.
DeepSeek (La percée chinoise dans l'IA ouverte)
Série de modèles ouverts révolutionnaires issus du laboratoire chinois DeepSeek (V3, R1). Elle démontre un niveau d'excellence inégalé en codage et en raisonnement, à un coût 10 à 20 fois inférieur aux équivalents commerciaux occidentaux.
Comment exécuter un LLM en local : configuration, modèles et optimisation
Guide complet pour l'exécution de réseaux de neurones locaux sur votre PC : exigences matérielles, déploiement d'Ollama et d'Open WebUI, aperçu de Llama 3, Qwen 2.5, DeepSeek et quantification GGUF.
RLVR (Reinforcement Learning with Verifiable Rewards)
Méthode de post-entraînement et d'optimisation du raisonnement des agents IA, où la fonction de récompense repose sur des vérifications mathématiques objectives, des compilateurs et des tests unitaires, plutôt que sur des évaluations humaines subjectives.