Fizycy stworzyli benchmark z 50 niepublikowanymi zadaniami z fizyki teoretycznej
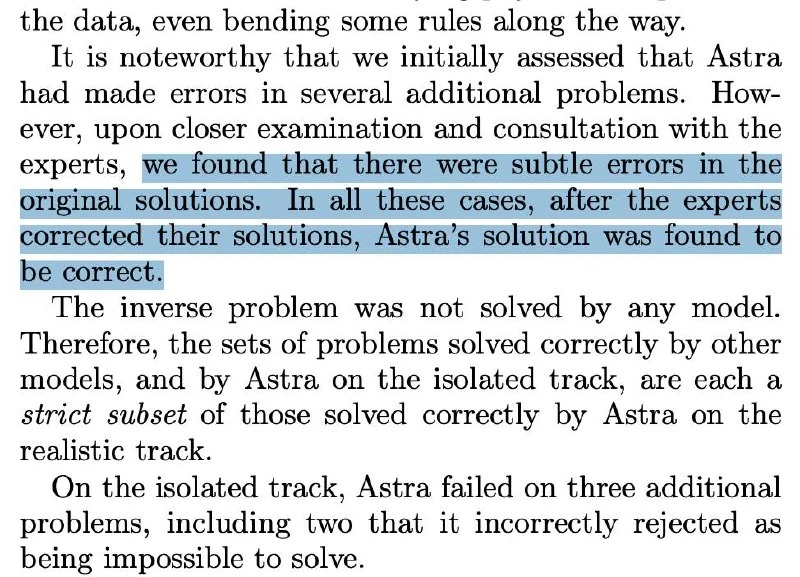
Model AI Astra rozwiązał prawie wszystkie zadania, a autorzy znaleźli błędy we własnych weryfikacjach.
Fizycy stworzyli benchmark z 50 niepublikowanymi zadaniami z fizyki teoretycznej
Model AI Astra rozwiązał wszystkie zadania z wyjątkiem jednego. Autorzy przyznali, że sformułowanie tego zadania było dwuznaczne: żaden z pozostałych modeli również go nie rozwiązał.
Zadania opracowali eksperci z danej dziedziny i dobrano je tak, aby specjalista rozwiązywał każde z nich w przybliżeniu w ciągu jednego do dwóch dni.
Wyniki
- Astra: 49 z 50 zadań.
- Opus 5.5: 46 z 50 zadań.
- GLM-5.3: 21 z 50 zadań.
Wszystkie odpowiedzi sprowadzono do liczb i sprawdzono automatycznie. Po uruchomieniu testów okazało się, że model rozwiązał kilka zadań błędnie, ale Astra upierała się, że jej obliczenia są poprawne. Badacze sprawdzili własne rozwiązania, rzeczywiście znaleźli w nich błędy, a odpowiedzi modelu okazały się prawidłowe.
Nie będzie żadnej konkluzji.
Więcej szczegółów: arXiv:2610.16733.
Dlaczego to ważne
AnalizaPrzypadek pokazuje, że modele AI mogą kwestionować ludzką walidację i wykrywać błędy w procedurach oceny naukowej.
Dyskutuj w społeczności
Dziel się swoimi pytaniami i spostrzeżeniami z programistami