DeepSeek aktualizuje model V4 Flash w API
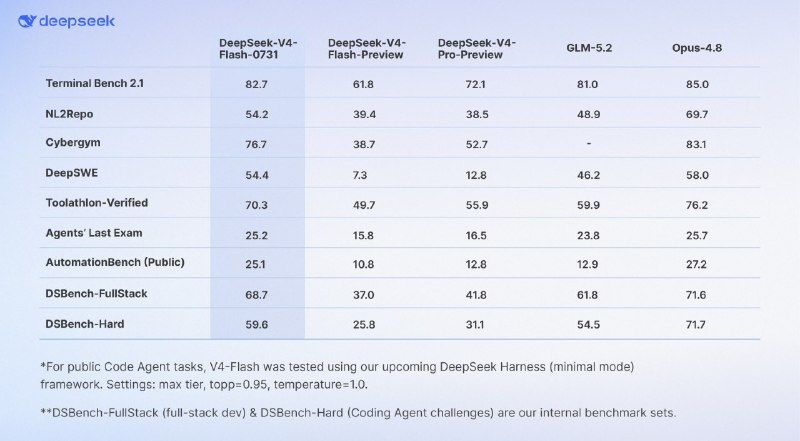
DeepSeek wprowadził nową wersję modelu V4 Flash, która przewyższa poprzednie generacje w benchmarkach i oferuje lepszą wydajność kosztową. Model jest dostępny wyłącznie przez API, a pełne otwarcie wag ma nastąpić w przyszłości.
DeepSeek aktualizuje model V4 Flash w API
Nowa wersja V4-Flash-0731 osiąga lepsze wyniki niż GLM 5.2 oraz V4 Pro Preview w testach porównawczych. Mimo że model wciąż posiada 284 miliardy parametrów (z czego aktywnych jest 13 miliardów), według analiz Artificial Analysis zużywa on zbliżoną liczbę tokenów co jego poprzednik. Dzięki temu rozwiązanie jest znacznie tańsze w przeliczeniu na zadanie niż GPT 5.6 Luna, nawet przy uwzględnieniu nowych cen. Należy jednak zaznaczyć, że Luna rozwiązuje zadania szybciej i wykorzystuje mniej tokenów.
Nowy model działa poprzez Responses API i jest w pełni kompatybilny z Codexem. Dodatkowo DeepSeek zapowiedział rychłe udostępnienie własnego agenta AI.
Wagi modelu nie zostały jeszcze upublicznione. Aktualnie V4 Flash jest dostępny wyłącznie przez API, podczas gdy starsza wersja pozostaje dostępna w czacie. Oczekuje się, że aktualizacja modelu V4 Pro zostanie wydana na początku sierpnia.
Dlaczego to ważne
AnalizaAktualizacja podkreśla rosnącą konkurencję na rynku modeli AI, oferując developerom narzędzia o wyższej efektywności kosztowej. To istotny sygnał dla branży, wskazujący na trend optymalizacji wydajności przy zachowaniu niskich cen.
Dyskutuj w społeczności
Dziel się swoimi pytaniami i spostrzeżeniami z programistami