Thinking Machines wydało zapętlony transformer Inkling 2 Mini
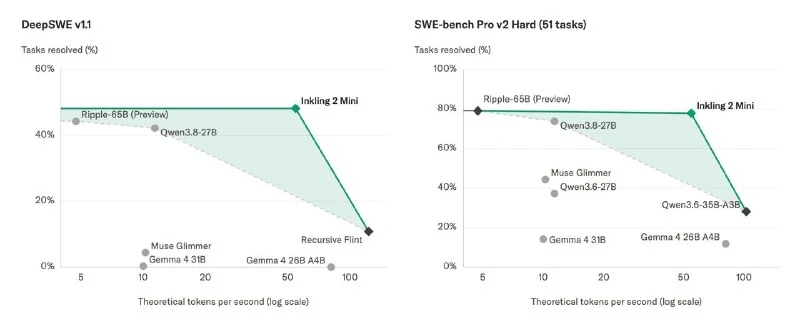
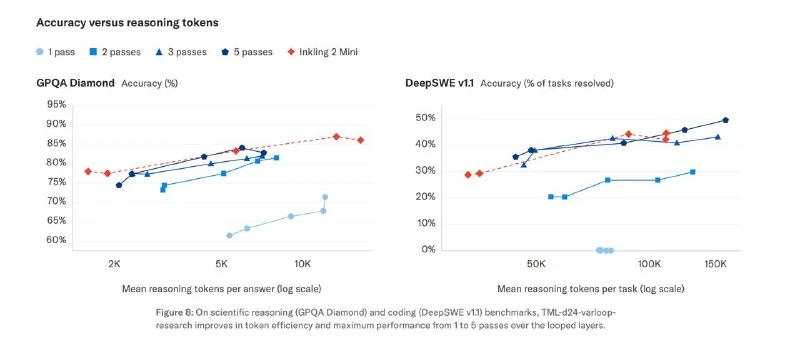
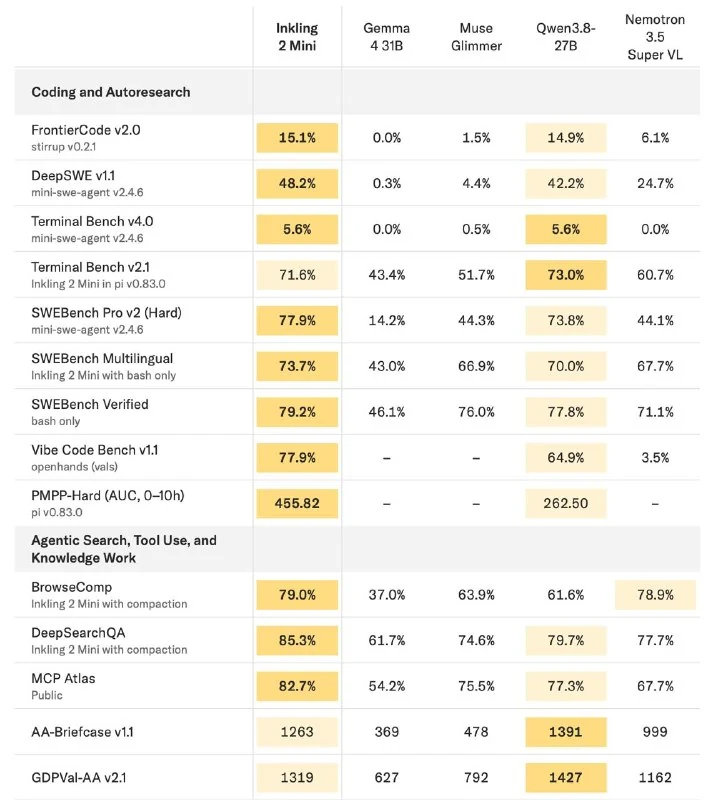
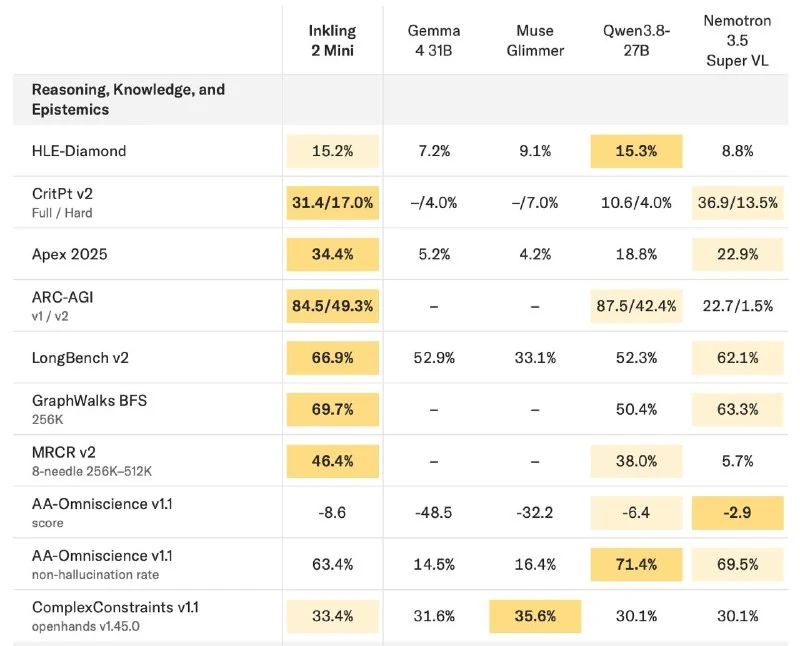
Thinking Machines, startup założony przez Mirę Murati, wydał Inkling 2 Mini — model oparty na architekturze looped transformer. To samo podejście, według spekulacji, mogło stanowić podstawę GPT-6 Astra.
Główna idea jest prosta: zamiast przepuszczać ukryty stan przez stały stos różnych warstw dokładnie raz, model wielokrotnie wykonuje ten sam blok warstw przed wygenerowaniem następnego tokenu. Dodaje to głębi rozumowaniu bez zwiększania liczby parametrów i bez dodatkowego zużycia tokenów na rozumowanie.
Wiele osób przypuszcza, że ta architektura mogła również wpłynąć na Fable 5.2 i GPT Sol. Zapętlanie warstw może tłumaczyć niedawną obniżkę kosztów modeli i lepszą efektywność zużycia tokenów obserwowaną w ostatnich miesiącach.
Thinking Machines wydało kompaktową wersję looped transformer przeznaczoną do lokalnego uruchamiania:
- łącznie 26,4B parametrów;
- około 3,4B aktywnych parametrów;
- około 5,4B aktywacji wag na token dzięki powtórnym przejściom przez warstwy.
Model ma 24 warstwy zorganizowane w cztery bloki po sześć warstw. Pierwszy i ostatni blok są wykonywane raz, a dwa środkowe bloki trzy razy każdy. W efekcie na token przypada 48 zastosowań warstw. Ponownie przepuszczane są tylko środkowe warstwy, ponieważ, jak piszą autorzy, odpowiadają one za bardziej abstrakcyjne rozumowanie. W testach dało to znacznie lepsze wyniki niż zapętlanie ostatnich 12 warstw.
W benchmarkach model osiąga poziom porównywalny z Qwen3.8-27B, a w niektórych metrykach nawet wyższy, mimo mniejszej liczby parametrów. Do lokalnego wdrożenia to naprawdę interesująca opcja.
Dlaczego to ważne
AnalizaInkling 2 Mini pokazuje, że zapętlone transformery mogą zwiększać głębię rozumowania bez proporcjonalnego wzrostu rozmiaru modelu. Jest to ważne dla lokalnego i edge AI, gdzie pamięć i moc obliczeniowa są ograniczone.
Dyskutuj w społeczności
Dziel się swoimi pytaniami i spostrzeżeniami z programistami
Powiązane w ekosystemie
Praktyczne poradniki, kluczowa terminologia i skille agentów
Thinking Machines wydało Inkling 2 Mini — model z otwartymi wagami do lokalnego kodowania
Thinking Machines udostępniło Inkling 2 Mini, model z otwartymi wagami i cykliczną architekturą transformera, który działa lokalnie na Macu i pozwala programować bez internetu.
OpenAI wydało modele GPT 6.2 Astra i Sol
OpenAI przedstawiło GPT 6.2 Astra i Sol; Astra prowadzi w testach agentów i oferuje bardziej konkurencyjne ceny.
Część I. Architektura agentów AI: fundamentalne elementy
Dziesięć fundamentalnych elementów współczesnego agenta: taksonomia modeli, pętla runtime, techniki promptowania, destylacja, umiejętności (skills), pamięć, wywoływanie funkcji oraz ekonomia jednostkowa.
Część II. Architektura agentów AI: od modelu do pamięci i narzędzi
Głęboka analiza inżynierska: tokenizacja, cache KV, determinizm próbkowania, stos treningowy, kwantyzacja, inżynieria kontekstu, stos bezpieczeństwa, produkcyjny RAG, ReAct oraz systemy multiagentowe typu swarm.