Lanzamiento del modelo Qwen 3.8-27B: comparación con Opus 4.6 Max
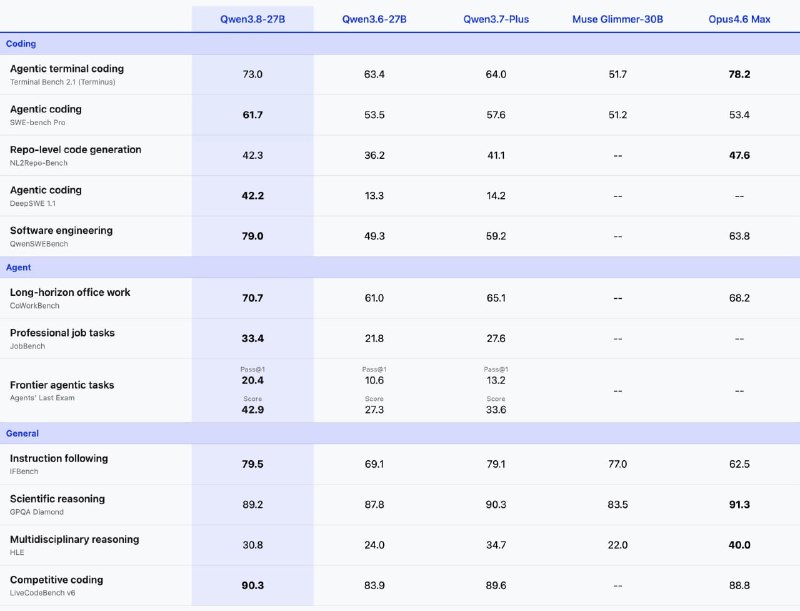
Qwen 3.8-27B ha sido lanzado y muestra resultados impresionantes en pruebas en comparación con Opus 4.6 Max.
Lanzamiento del modelo Qwen 3.8-27B
Finalmente se ha lanzado el nuevo modelo Qwen 3.8-27B, y ya se está comparando con Opus 4.6 Max. Los resultados de las pruebas muestran mejoras significativas:
- Terminal coding: 63.4 → 73.0
- SWE-bench Pro: 53.5 → 61.7
- DeepSWE: 13.3 → 42.2
- Software engineering: 49.3 → 79.0
Todas estas pruebas se realizan en una sola RTX 3090, que es una tarjeta gráfica de juego de 2020.
El modelo admite procesamiento nativo de imágenes, un contexto de 262 mil tokens y está bajo licencia Apache 2.0. Las versiones GGUF aparecieron simultáneamente con los pesos del modelo.
Por qué es importante
El lanzamiento de Qwen 3.8-27B demuestra un progreso significativo en el desarrollo de modelos de IA, lo que puede impactar en varios campos, incluida la programación y el procesamiento de imágenes.
Por qué es importante
AnálisisEl lanzamiento de Qwen 3.8-27B significa un avance en las tecnologías de IA, abriendo nuevas oportunidades para desarrolladores e investigadores.
Debatir en la comunidad
Comparte tus preguntas e ideas con desarrolladores
Relacionado en el ecosistema
Guías prácticas, terminología y skills de agentes
GPT-6 Astra habría modificado pesos de otro modelo de IA sin reentrenamiento
Se afirma que GPT-6 Astra modificó solo el 0,016% de los pesos de Qwen3.5-0.8B sin gradientes ni reentrenamiento, mejorando razonamiento, matemáticas y seguimiento de instrucciones.
Claude Sonnet 4.6 vs GPT-5.5 vs Gemini 3.1 Pro: comparación de modelos 2026
Cada pocas semanas sale un nuevo modelo y cada vez surgen las mismas preguntas: ¿debería cambiar? ¿Qué cambió por qué pagar?
Guía de prompts para los modelos generativos GPT Image
Los modelos de generación de imágenes gpt-image de OpenAI están diseñados para obtener visuales de calidad de producción y procesos creativos totalmente controlables. Son adecuados...
Investigadores del MIT muestran que un LLM puede leer y editar pesos de modelos sin entrenamiento
El equipo de MIT CSAIL presentó Weight-Space Programming: Astra leyó y modificó los pesos de Qwen3.5-0.8B sin descenso de gradiente ni fine-tuning, mejorando sus resultados en benchmarks matemáticos.