Revolut масово перейшла на локальні GLM-моделі для коду
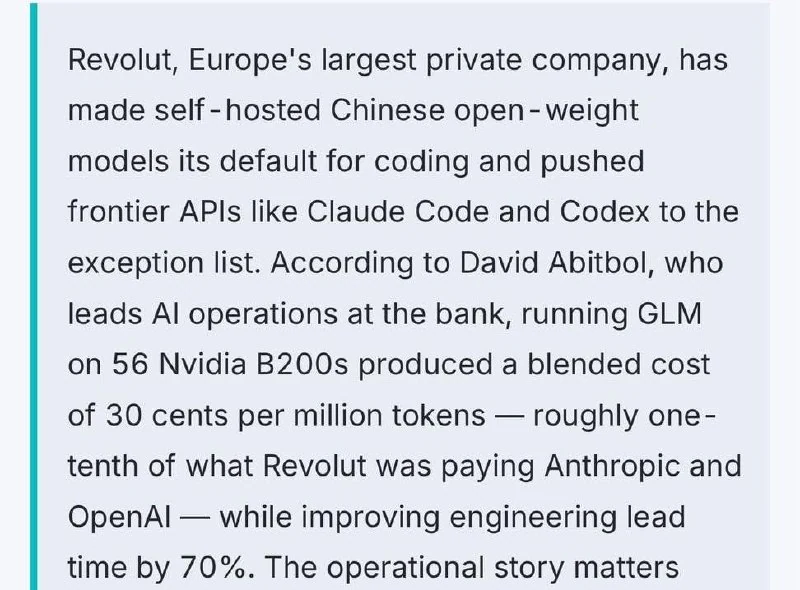
Revolut перевела близько 2000 інженерів на локально розгорнуті моделі GLM для програмування. Claude Code і Codex тепер використовують лише в виняткових випадках.
Для цього компанія залучила 56 прискорювачів Nvidia B200. Середня вартість склала близько 30 центів за мільйон токенів — приблизно вдесятеро менше, ніж Revolut платила Anthropic і OpenAI.
При цьому час виконання інженерних задач зменшився на 70%.
Найцікавіше полягає в іншому: поліпшення стали помітними, коли інженерам більше не довелося економити токени. Вони перестали звертатися до ШІ лише для складних задач і почали використовувати його майже повсюдно.
Передові пропрієтарні моделі поступово стають винятком, а моделі з відкритими вагами — основним інструментом. Для кожної ШІ-компанії, яка готується до виходу на біржу, це серйозна проблема з ціноутворенням.
Чому це важливо
АналітикаПоказово, що локальні відкриті моделі можуть стати робочим стандартом для інженерних команд, а не лише дешевшою альтернативою для прототипів. Це тисне на бізнес-моделі пропрієтарних ШІ-вендорів і їхнє IPO-ціноутворення.
Обговорити новину у спільноті
Діліться своїм досвідом та думками з ШІ-розробниками
Пов'язані матеріали екосистеми
Практичні гайди, термінологія та агентські скіли
Частина II. Архітектура ШІ-агентів: від моделі до пам'яті та інструментів
Глибоке інженерне занурення: токенізація, KV-кеш, детермінізм семплінгу, тренувальний стек, квантування, контекстна інженерія, стек безпеки, виробничий RAG, ReAct та мультиагентні swarm-системи.
Frontier Models (Фронтирні моделі ШІ)
Найпотужніший клас штучного інтелекту на передньому краї світових досліджень (Claude 3.7 Sonnet, OpenAI o3/GPT-4.5, Gemini 2.0 Pro), що визначає межу сучасних можливостей міркування, автономності та кодування.
Mistral AI (Європейські відкриті та ефективні моделі)
Серія високоефективних відкритих та комерційних моделей від французького стартапу Mistral AI (Mistral 7B, Mixtral 8x7B, Mistral Large). Відомі компактністю, швидкістю та повагою до приватності даних.
Дослідники MIT показали, що GPT-6 Astra може покращувати інші ШІ-моделі, змінюючи їхні ваги
У експерименті Astra підвищила точність Qwen3.5-0.8B на бенчмарку MATH-500 із 7,9% до 48,1%, змінивши лише 0,016% ваг моделі.