Qwen4-Max já está disponível: 50% menos tokens e custo menor por tarefa
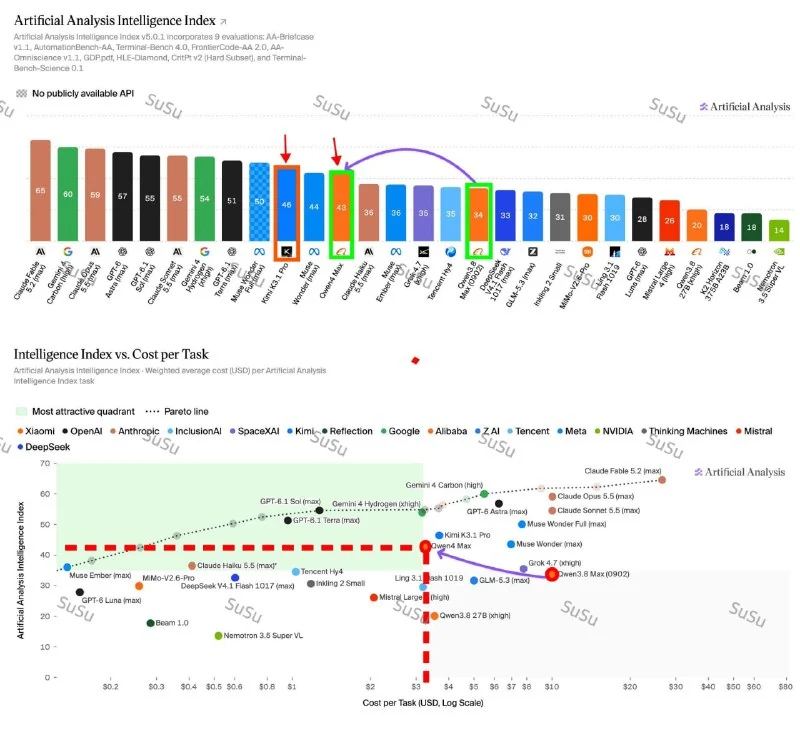
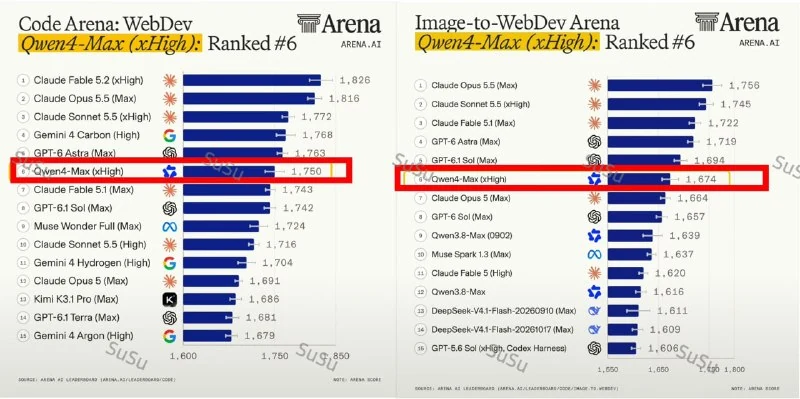
Qwen4-Max chega com arquitetura MoE, contexto de 1 milhão de tokens, suporte integrado a imagens e redução significativa de custos.
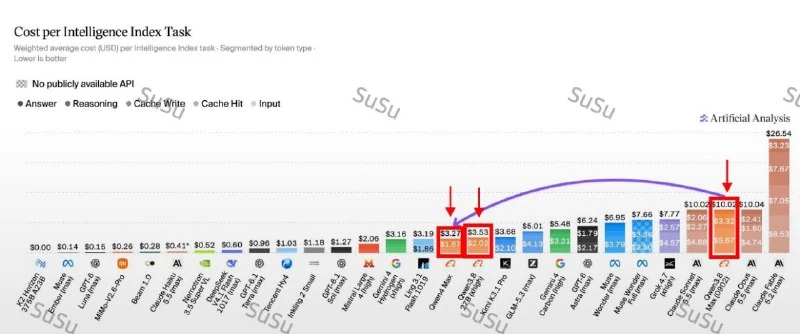
Qwen4-Max já está disponível. Segundo o anúncio, o modelo usa 50% menos tokens e é mais de 60% mais barato por tarefa concluída.
Principais recursos:
- Uso de tokens reduzido em 50%.
- Custo por tarefa reduzido em mais de 60%.
- Arquitetura MoE (Mixture-of-Experts).
- Janela de contexto de 1 milhão de tokens.
- Suporte integrado a imagens.
Qwen4-Max não é voltada apenas para programação, mas também para tarefas práticas: modelagem 3D, manufatura, finanças, direito, medicina e pesquisa científica.
A API já está disponível na página oficial do Qwen4-Max. Os pesos abertos do Qwen4-27B devem ser lançados mais tarde.
Por que isso importa
AnáliseÉ relevante para equipes que buscam modelos multimodais mais baratos para contextos longos e fluxos reais.
Debater na comunidade
Compartilhe suas dúvidas e insights com desenvolvedores
Relacionado no ecossistema
Guias práticos, terminologia essencial e skills de agentes
Qwen-4 Max é lançado oficialmente: modelo para agentes e tarefas de longo prazo
O Qwen-4 Max é posicionado como modelo para tarefas agênticas e de longo prazo, com menor uso de tokens e custo reduzido em comparação ao Qwen-3.8.
Tencent lança Hy4 Flash, concorrente do Claude Haiku com contexto de 1 milhão de tokens
A Tencent lançou o Hy4 Flash, um modelo multimodal nativo com janela de contexto de 1 milhão de tokens e baixo custo de inferência. A empresa afirma que ele é comparável ao Claude Haiku 5.5 no modo High para tarefas do dia a dia.
Guia completo do Higgsfield Cinema Studio 4.0: controle de cena, Soul 2.0 e automação via API
Análise prática detalhada da grande atualização do Higgsfield: Cinema Studio 4.0, personagens consistentes com Soul 2.0, geração via API e um pipeline UGC pronto para uso.
Parte I. Arquitetura de Agentes de IA: Blocos Fundamentais
Dez blocos fundamentais de um agente moderno: taxonomia de modelos, loop de runtime, técnicas de prompting, destilação, habilidades (skills), memória, function calling e economia por unidade.