Qwen 3.8 Flash Next Lançado: Novo Modelo de 125B-A6B
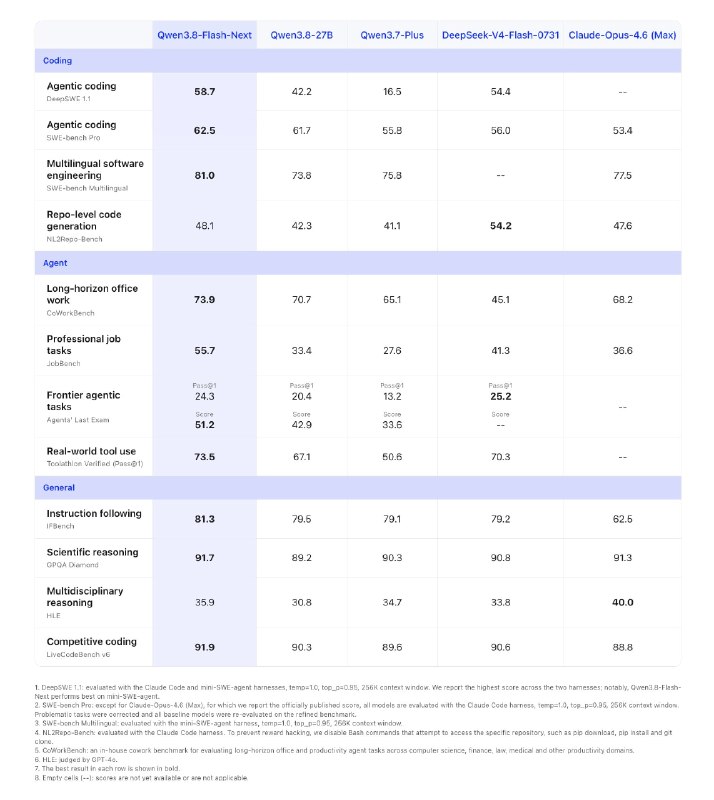
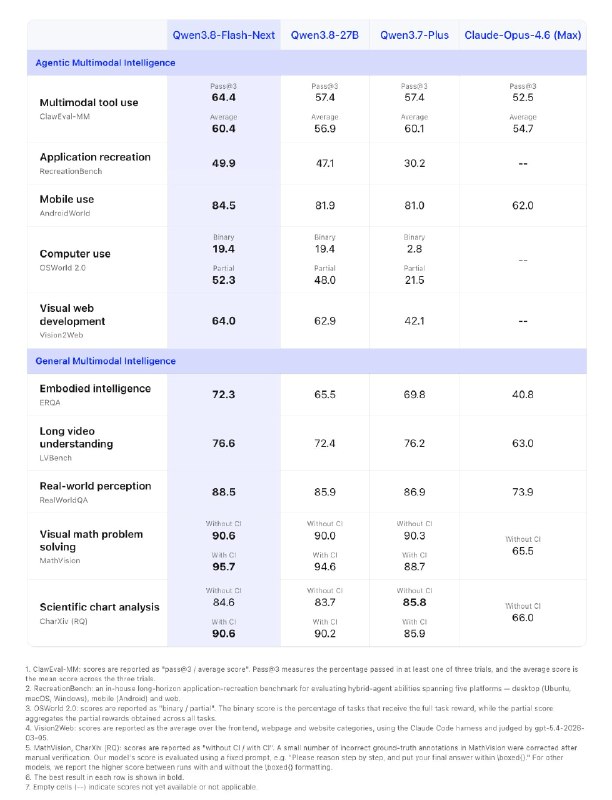
O Qwen 3.8 Flash Next é um novo modelo de 125B-A6B que apresenta desempenho excelente em comparação com versões anteriores e concorrentes diretos.
Qwen 3.8 Flash Next Lançado — Um Novo Modelo de 125B-A6B
Este é um modelo de 125B-A6B com 51B de parâmetros Engram, baseado na arquitetura Qwen 4. Ele supera o Qwen 3.8 27B em todos os benchmarks e compete muito bem com o DeepSeek V4 Flash. O modelo já conta com suporte para vLLM e SGLang.
Formato e Capacidades
Um formato interessante para modelos que permite executá-los eficientemente em máquinas locais com 128GB de memória — como DGX Spark, Mac e Strix Halo. Precisamos de mais modelos como este. Recentemente, não havia modelos nesta categoria de peso, pois os modelos de ~30B rodavam em hardware muito mais fraco, enquanto o DeepSeek V4 Flash e similares não cabiam mais.
Recursos Adicionais
Por que isso importa
AnáliseEste modelo abre novas possibilidades para a computação local no campo da IA, o que pode impactar significativamente o desenvolvimento tecnológico. Ele demonstra competitividade no mercado, crucial para o progresso contínuo desta área.
Debater na comunidade
Compartilhe suas dúvidas e insights com desenvolvedores
Relacionado no ecossistema
Guias práticos, terminologia essencial e skills de agentes
GPT-6 Astra teria alterado pesos de outro modelo de IA sem re-treinamento
A GPT-6 Astra teria alterado apenas 0,016% dos pesos do Qwen3.5-0.8B sem gradientes ou re-treinamento, melhorando raciocínio, matemática e seguimento de instruções.
Guia de prompts para modelos generativos GPT Image
Os modelos de geração de imagens gpt-image da OpenAI foram criados para obter visuais de qualidade de produção e processos criativos totalmente controláveis. São adequados tanto para design profissional...
Claude Sonnet 4.6 vs GPT-5.5 vs Gemini 3.1 Pro: Comparação de Modelos 2026
A cada poucas semanas, surge um novo modelo, e sempre as mesmas perguntas: vale a pena migrar? O que mudou? Pelo que pagar?
Pesquisadores do MIT mostram que um LLM pode ler e editar pesos de modelos sem treinamento
O MIT CSAIL apresentou Weight-Space Programming: Astra leu e alterou os pesos do Qwen3.5-0.8B sem gradiente descendente nem fine-tuning, melhorando os resultados em benchmarks matemáticos.