PrismML prezentuje największy na świecie model AI do wdrożeń na smartfonach
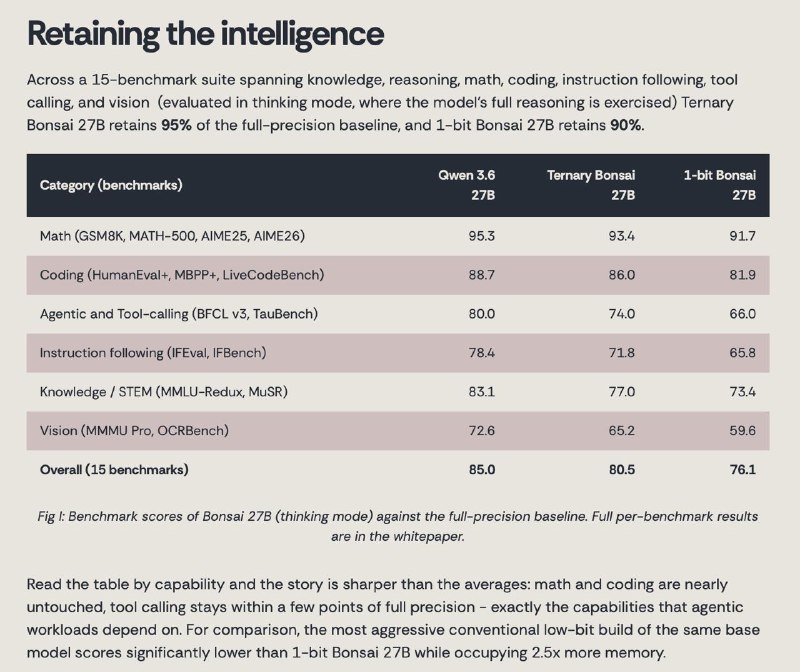
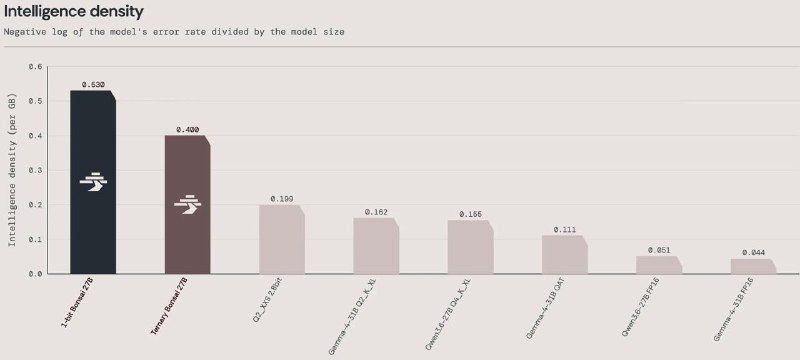
Startup PrismML zaprezentował model Bonsai o 27 miliardach parametrów, zoptymalizowany pod kątem uruchamiania bezpośrednio na urządzeniach mobilnych. Dzięki innowacyjnej metodzie szkolenia z uwzględnieniem kwantyzacji, model zachowuje wysoką jakość przy drastycznym zmniejszeniu rozmiaru pamięci.
Startup PrismML Announces the Largest Model in the World for Smartphone Deployment
Nowo zaprezentowany model Bonsai dysponuje 27 miliardami parametrów. Zazwyczaj taki model nie może być uruchomiony na telefonie: w surowej postaci 16-bitowej zajmowałby około 54 GB, a nawet po skompresowaniu do 4 bitów wciąż ważyłby około 18 GB. Po prostu nie mieści się on w pamięci smartfona.
Jednak Bonsai, mimo swoich imponujących rozmiarów, został specjalnie zoptymalizowany pod kątem lokalnego wdrożenia. Model opiera się na architekturze Qwen3.6-27B, ale deweloperzy zastosowali nie standardową kwantyzację, lecz technikę zwaną Quantization-Aware Training (Szkolenie z Uwzględnieniem Kwantyzacji).
Oznacza to, że wagi modelu nie zostały po prostu obcięte, lecz stopniowo uczono je adaptacji do wartości dyskretnych. Technicznie rzecz biorąc, podczas przejścia w przód (forward pass) wagi są zaokrąglane do wartości dyskretnych, a model dokonuje predykcji przy użyciu tych wartości, tak jak w finalnej, skompresowanej wersji. Jednak podczas przejścia wstecz (backward pass) gradienty są obliczane tak, jakby zaokrąglenie nie miało miejsca, co pozwala modelowi otrzymywać znaczące sygnały do aktualizacji wag, mimo że same wagi są dyskretne. Innymi słowy, model efektywnie uczy się optymalnego skalowania swoich wag.
Dzięki temu rozwiązaniu inżynieryjnemu model zachowuje ponad 89–95% jakości pełnowymiarowej wersji, zajmując przy tym 9–14 razy mniej pamięci. W porównaniu z konwencjonalną kwantyzacją, która pochłania znaczną część jakości, są to wyniki wręcz fenomenalne.
Dostępna jest opcja trójkowa (wagi przyjmują wartości -1, 0 lub +1; zajmuje ~5,9 GB) oraz klasyczna wersja 1-bitowa (3,9 GB). Ta druga bez problemu mieści się w iPhone 17 Pro. Oba warianty są multimodalne. Kontekst wynosi 262 tysiące tokenów. Model jest open-source’em udostępnionym na licencji Apache 2.0.
Dlaczego to ważne
AnalizaTen model otwiera nowe możliwości dla wdrażania sztucznej inteligencji na urządzeniach mobilnych, potencjalnie transformując sposób interakcji użytkowników z technologią. Stanowi on dowód na to, że innowacyjne podejścia do kwantyzacji mogą zachować wysoką jakość generatywnej AI przy jednoczesnym znacznym redukowaniu wymagań pamięciowych.
Dyskutuj w społeczności
Dziel się swoimi pytaniami i spostrzeżeniami z programistami
Powiązane w ekosystemie
Praktyczne poradniki, kluczowa terminologia i skille agentów
Kwantyzacja (Model Quantization)
Technologia matematycznej kompresji wag i aktywacji sieci neuronowej poprzez przejście z wysokiej precyzji (FP16/BF16) do formatów o niskiej rozdzielczości (FP8, INT8, INT4, GGUF) w celu znaczącej oszczędności pamięci.
JSON — dane ustrukturyzowane dla aplikacji, API i agentów AI
Kompletny praktyczny przewodnik po formacie JSON: zasady składniowe, serializacja za pomocą parse/stringify, praca z REST API, JSON Schema oraz strukturalne wyjście dla sztucznej inteligencji.
Formaty DOCX i XLSX: kiedy potrzebny jest pełnoprawny dokument końcowy od AI
Kompletny praktyczny przewodnik po generowaniu i przetwarzaniu dokumentów DOCX oraz arkuszy XLSX za pomocą AI: porównanie z Markdown i CSV, inżynieria promptów, praca z formułami oraz automatyzacja w kodzie.
AWQ i kwantyzacja GPU uwzględniająca aktywacje
Metody 4-bitowej kompresji wag modeli językowych, zoptymalizowane pod architekturę rdzeni tensorowych NVIDIA w celu maksymalizacji przepustowości oraz zachowania krytycznych kanałów aktywacji.