Стартап PrismML анонсировал крупнейшую модель в мире для запуска на смартфонах
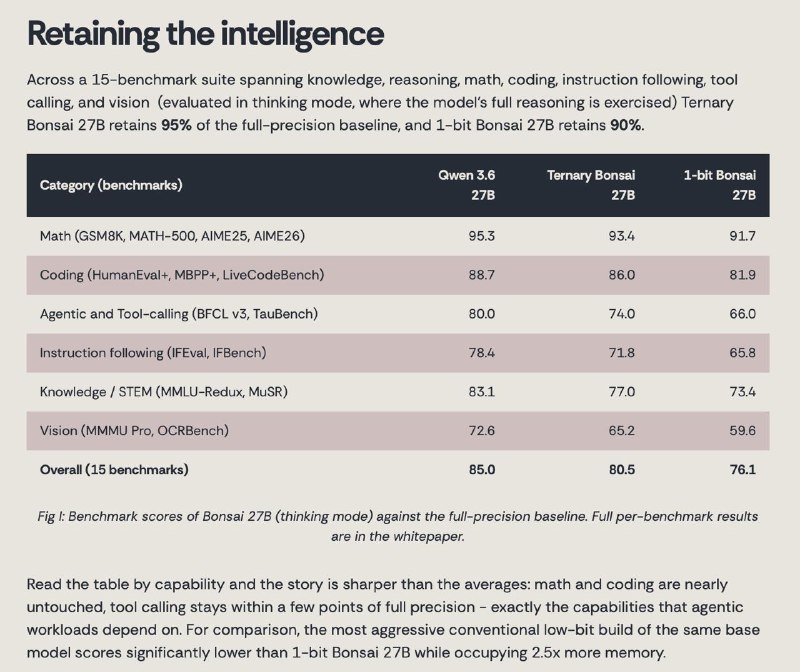
Стартап PrismML представил модель Bonsai с 27 миллиардами параметров, оптимизированную для запуска на смартфонах. Она сохраняет высокое качество при значительном уменьшении размера памяти.
Стартап PrismML анонсировал крупнейшую модель в мире для запуска на смартфонах
В представленной модели Bonsai 27 миллиардов параметров. Обычно на телефоне такую модель не запустишь: в сыром 16-bit она будет занимать примерно 54GB, и даже если сжать её до 4-bit, всё равно будет около 18GB. На смартфон не поместится.
Bonsai же, при своём внушительном размере, оптимизирован именно под локальный запуск. Модель основана на Qwen3.6-27B, но разработчики использовали не обычное квантование, а технику Quantization-Aware Training.
Это значит, что веса не обрубали, а учили постепенно адаптироваться к дискретным значениям. Технически, на прямом проходе веса округляются до дискретных значений, и модель считает предсказание уже с ними, как в финальной сжатой версии. Но на обратном проходе градиенты вычисляются так, будто округления не было, и это позволяет модели получать осмысленный сигнал для обновления весов, несмотря на то, что сами веса дискретны. То есть модель как бы сама подбирает, как масштабировать свои веса наилучшим образом.
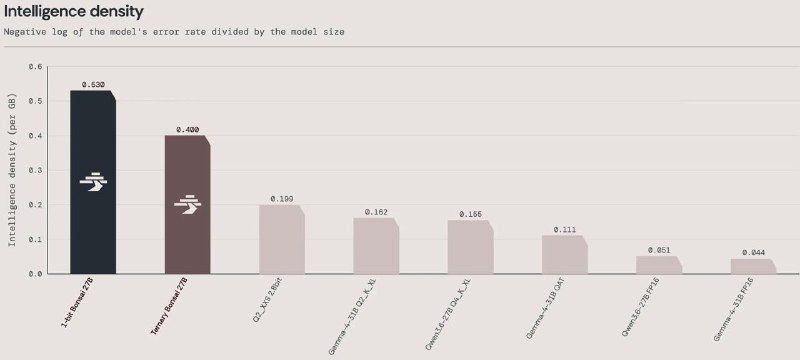
Собственно, благодаря такой инженерии, модель сохраняет свыше 89–95% качества полноразмерной версии, и при этом занимает в 9–14 раз меньше памяти. Для обычного квантования, которое съедает львиную долю качества, это просто феноменальные цифры.
Есть тернарный вариант (веса −1, 0 или +1; занимает ~5.9GB) и классический 1-bit (3.9GB). Второй легко укладывается в iPhone 17 Pro. Оба варианта мультимодальные. Контекст 262K токенов. Опенсорс под лицензией Apache 2.0.
Почему это важно
АналитикаЭта модель открывает новые возможности для использования искусственного интеллекта на мобильных устройствах, что может существенно изменить способ взаимодействия пользователей с технологиями. Она демонстрирует, как инновационные подходы к квантованию могут сохранять высокое качество при уменьшении размера памяти.
Обсудить в сообществе
Делитесь опытом и мыслями с ИИ-разработчиками
Связанные материалы экосистемы
Практические гайды, терминология и агентские скиллы
JSON — структурированные данные для программ, API и AI-агентов
Полное практическое руководство по формату JSON: синтаксические правила, сериализация через parse/stringify, работа с REST API, валидация по JSON Schema и структурированный вывод для ИИ.
Форматы DOCX и XLSX: когда от ИИ требуется полноценный финальный документ
Практическое руководство по созданию и обработке документов DOCX и таблиц XLSX с помощью ИИ: сравнение с Markdown и CSV, промпт-инжиниринг, работа с формулами и автоматизация в коде.
AWQ & Activation-Aware GPU Quantization
Методы 4-битного сжатия весов языковых моделей, оптимизированные под архитектуру тензорных ядер NVIDIA для максимальной пропускной способности и сохранения критических каналов активации.
GGUF и Современные Стандарты Квантизации
Универсальный бинарный формат файлов для хранения и мгновенной загрузки квантизированных языковых моделей на процессорах и видеокартах в llama.cpp, Ollama и LM Studio.