NVIDIA lança Nemotron 3.5 Lightning: modelo aberto para agentes de IA
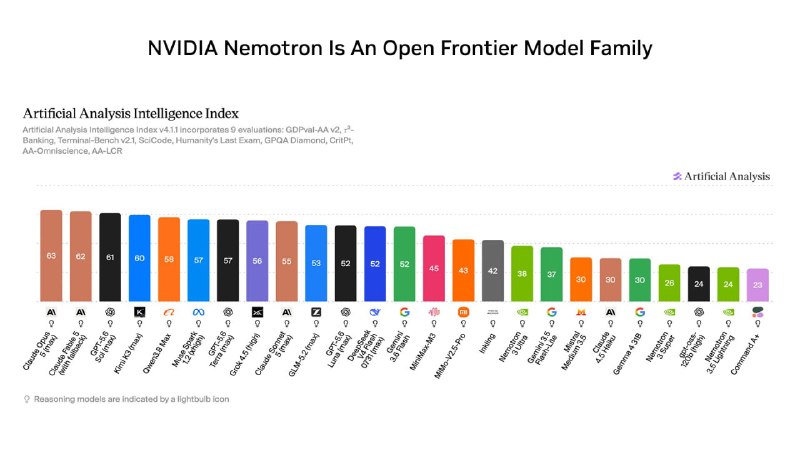
A NVIDIA apresentou o Nemotron 3.5 Lightning, um modelo de código aberto otimizado para velocidade e precisão em agentes de IA autônomos.
A NVIDIA disponibilizou o modelo aberto Nemotron 3.5 Lightning, projetado especificamente para agentes de IA que operam continuamente.
Este modelo possui 30 bilhões de parâmetros, dos quais apenas 3 bilhões são ativados por inferência. Como resultado, a velocidade de geração é até quatro vezes superior à de modelos comparáveis em tamanho.
Nos testes do PinchBench, o Nemotron 3.5 Lightning demonstrou uma precisão de 86% e concluiu 10.000 tarefas 35% mais rápido do que o Qwen3.6 35B, mantendo uma acurácia equivalente.
O modelo pode ser ajustado (fine-tuning) com dados personalizados, ferramentas e fluxos de trabalho específicos. Sua arquitetura compacta permite execução eficiente em hardware como o DGX Spark.
Juntamente com o lançamento, a NVIDIA abriu o código da biblioteca NeMo Switchyard, que distribui diferentes estágios do trabalho dos agentes entre modelos variados. Raciocínio complexo e planejamento podem ser atribuídos a modelos avançados, enquanto a execução massiva de tarefas fica a cargo do rápido Lightning.
A empresa também publicou os pesos, dados e receitas de treinamento. O modelo está disponível gratuitamente através da plataforma OpenRouter.
Por que isso importa
AnáliseEsta iniciativa democratiza o acesso a modelos de alta performance para desenvolvedores de agentes de IA, permitindo personalização profunda sem sacrificar a latência. A combinação de velocidade extrema e eficiência computacional posiciona o Nemotron 3.5 Lightning como uma solução viável para aplicações escaláveis em tempo real.
Debater na comunidade
Compartilhe suas dúvidas e insights com desenvolvedores
Relacionado no ecossistema
Guias práticos, terminologia essencial e skills de agentes
JSON — dados estruturados para aplicações, APIs e agentes de IA
Guia prático completo sobre o formato JSON: regras de sintaxe, serialização via parse/stringify, integração com REST API, JSON Schema e saída estruturada para inteligência artificial.
Formato CSV: Guia completo para automação e trabalho com IA
Guia prático sobre o uso do formato CSV em pipelines de IA: especificação RFC 4180, comparação com XLSX e JSON, limpeza e enriquecimento massivo de dados, codificação em Python e prompts prontos.
O Monopólio da Nvidia e a Plataforma CUDA
Análise do domínio tecnológico e econômico da corporação Nvidia no mercado de inteligência artificial. Como a plataforma de software CUDA (Compute Unified Device Architecture), criada em 2006, transformou placas de vídeo comuns para jogos na principal ferramenta computacional do planeta, e por que é tão difícil para os concorrentes (AMD, Intel) quebrar esse monopólio.
Memória de Vídeo (VRAM) para IA
A memória de vídeo da placa gráfica (Video RAM), onde são carregados os pesos da rede neural e a janela de contexto. É o principal gargalo de hardware: se o modelo não couber na VRAM, ele não será executado ou funcionará dezenas de vezes mais lentamente no processador comum.