Новый Haiku 5.5: дешевле в запуске, сильнее в коде и с настройкой effort
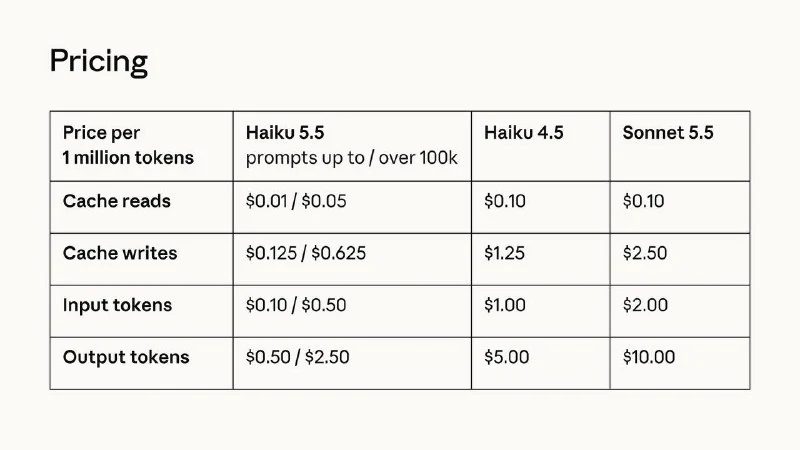
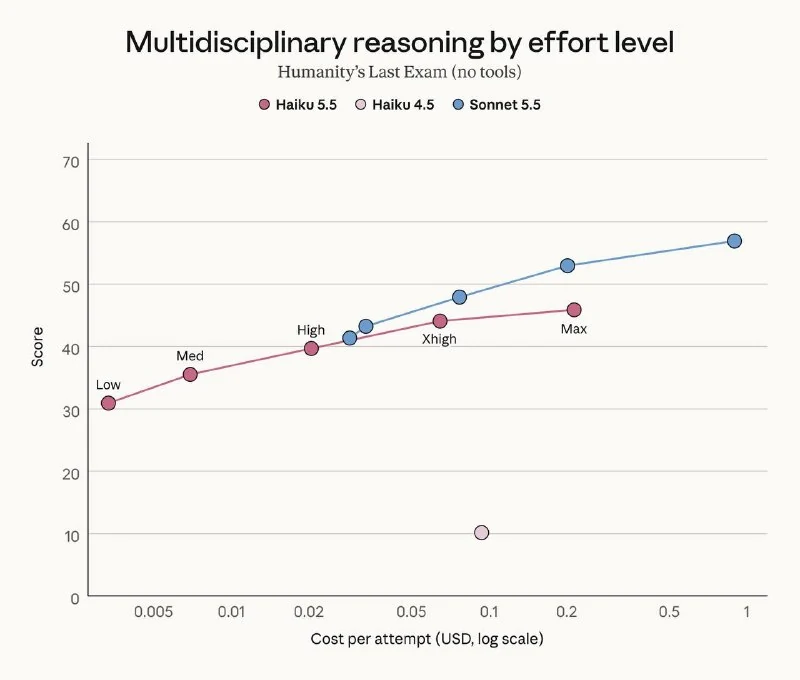
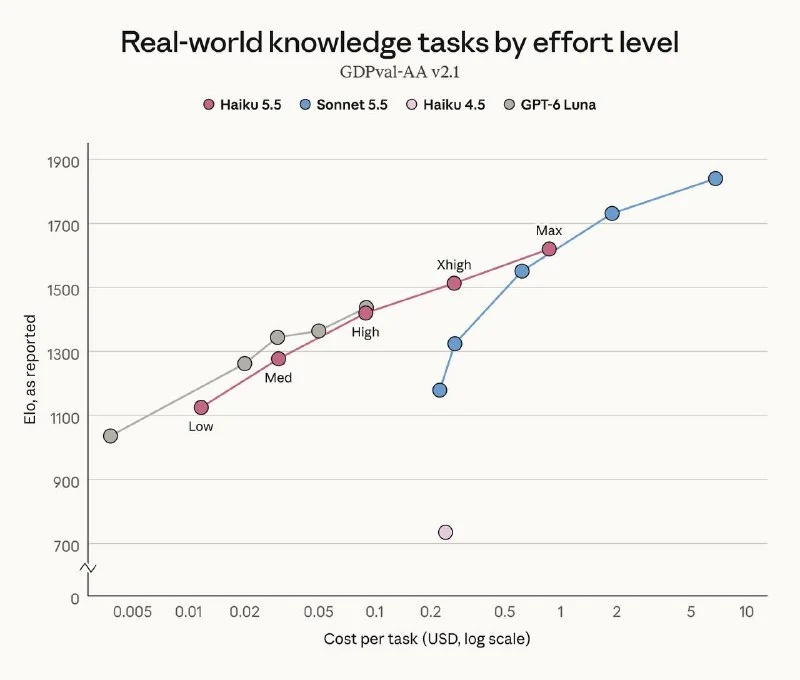
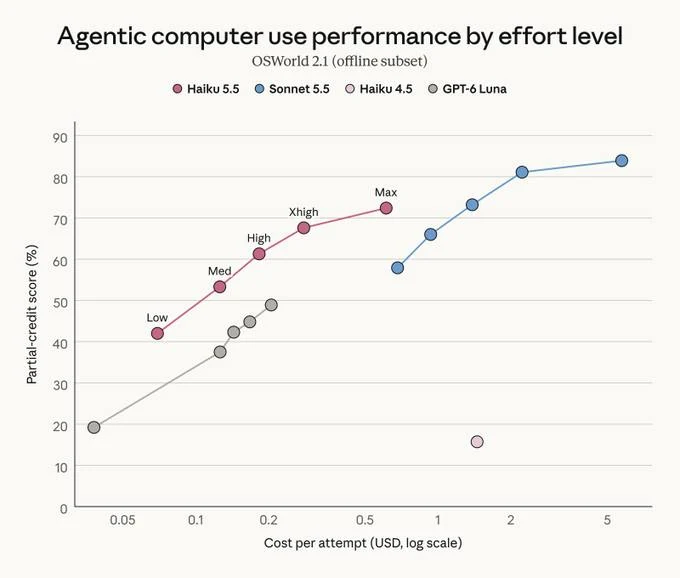
Новый Haiku 5.5 в среднем на 75% дешевле в запуске по сравнению с Haiku 4.5, с улучшениями в кодинге, работе с компьютером и задачах на знания, а также с новой настройкой effort.
Новый Haiku 5.5, сводка:
- В среднем запуск обходится на 75% дешевле Haiku 4.5.
- Хороший скачок в кодинге, работе с компьютером и задачах на знания.
- Сильно снизили цену: на задачах до 100K токенов модель стоит на 90% дешевле Haiku 4.5, на более длинных примерно вдвое дешевле.
- Добавили настройку
effort, которой раньше у Haiku не было.
Почему это важно
АналитикаСнижение цены и добавление `effort` делают Haiku 5.5 более доступным для масштабных задач и позволяют точнее управлять балансом стоимости и качества.
Обсудить в сообществе
Делитесь опытом и мыслями с ИИ-разработчиками
Связанные материалы экосистемы
Практические гайды, терминология и агентские скиллы
Google представила Gemini 4 Neon: модель обходит Claude Opus 5.5 и GPT-6.2 Sol в кодинге и агентных сценариях
Google представила Gemini 4 Neon — новую модель, которая, по заявленным результатам, превосходит Claude Opus 5.5 и GPT-6.2 Sol в большинстве тестов и задач.
Codex: базовый онбординг, настройки и первые задачи
Есть три способа работать с АИ при написании кода – и Codex закрывает самый амбициозный из них.
Token Burn Rate (Скорость сжигания токенов)
Критическая инженерная и финансовая метрика скорости потребления контекстных и генерационных токенов (и долларов в час) в агентских сессиях разработки с учетом кэширования промптов.
Thinking Machines выпустила Inkling 2 Mini — модель с открытыми весами для локального кода
Thinking Machines выпустила Inkling 2 Mini с открытыми весами и циклической архитектурой трансформера: модель можно запускать локально на Mac и использовать для программирования без интернета.