Новий Haiku 5.5: дешевший запуск, покращення в коді та налаштування effort
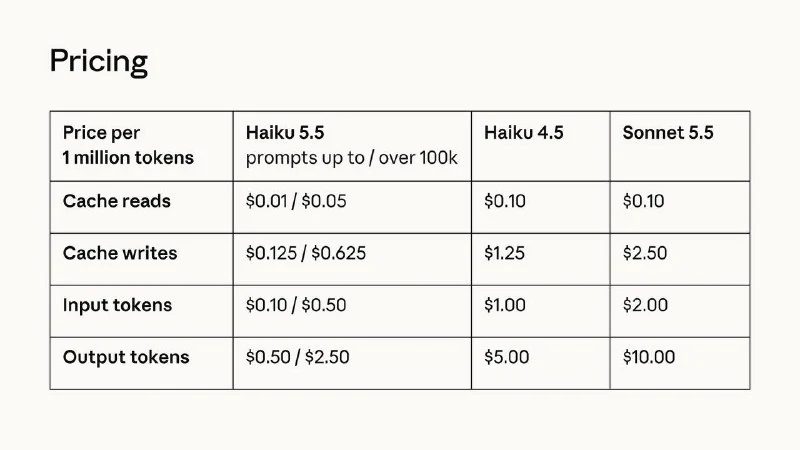
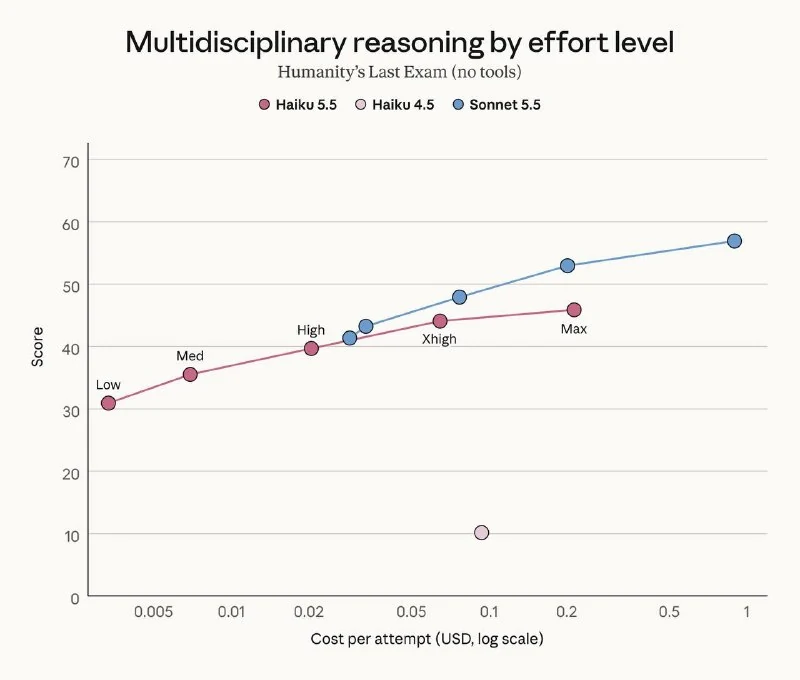
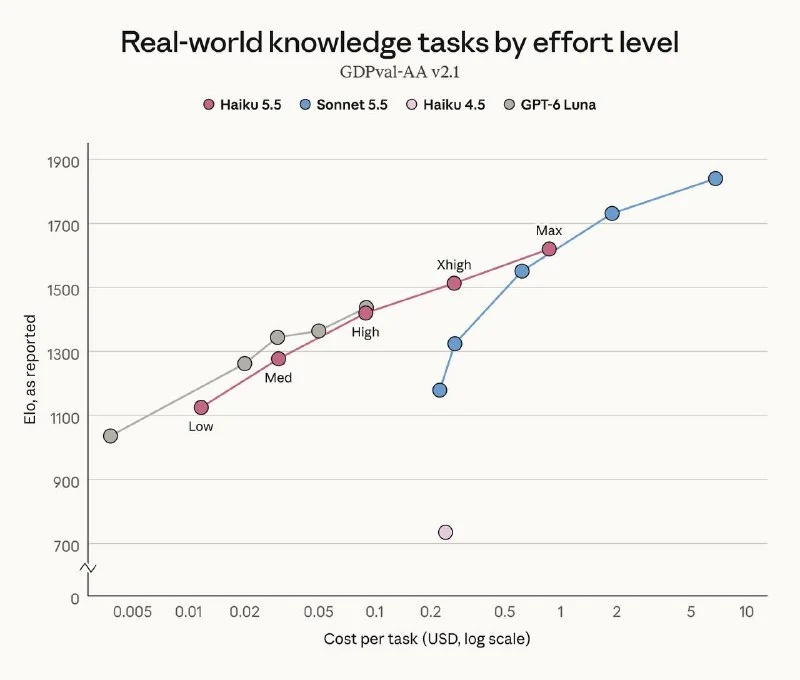
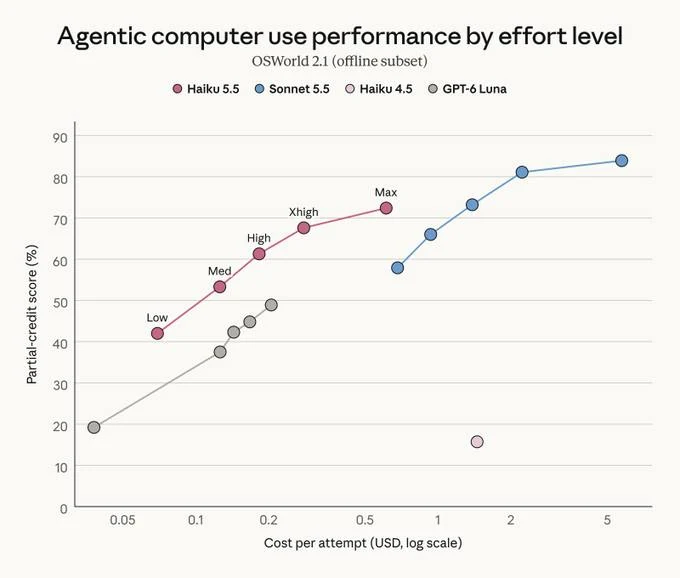
Новий Haiku 5.5 у середньому коштує на 75% менше за запуск порівняно з Haiku 4.5, має покращення в коді, роботі з комп’ютером і завданнях на знання, а також отримав налаштування effort.
Новий Haiku 5.5: короткий огляд
- У середньому запуск коштує на 75% дешевше, ніж Haiku 4.5.
- Є помітний стрибок у коді, роботі з комп’ютером і завданнях на знання.
- Ціни суттєво знижено: для завдань до 100K токенів модель коштує на 90% дешевше за Haiku 4.5, для довших — приблизно вдвічі дешевше.
- Додано налаштування
effort, якого раніше в Haiku не було.
Чому це важливо
АналітикаЗниження вартості та поява `effort` роблять модель зручнішою для масових застосувань і дають розробникам більше контролю над балансом ціни й якості.
Обговорити новину у спільноті
Діліться своїм досвідом та думками з ШІ-розробниками
Пов'язані матеріали екосистеми
Практичні гайди, термінологія та агентські скіли
Google представила Gemini 4 Neon: модель перевершує Claude Opus 5.5 і GPT-6.2 Sol у коді та агентних сценаріях
Google представила Gemini 4 Neon — нову ШІ-модель для кодування, логіки та агентних задач, яка за заявленими результатами обходить Claude Opus 5.5 і GPT-6.2 Sol у більшості тестів.
Codex: базовий онбординг, налаштування та перші завдання
Є три способи працювати з АІ при написанні коду - і Codex закриває найамбіційніший з них.
Token Burn Rate (Швидкість витрати токенів)
Критична інженерна та фінансова метрика швидкості споживання контекстних і генераційних токенів (та доларів на годину) в агентських сесіях розробки з урахуванням кешування промптів.
Thinking Machines випустила Inkling 2 Mini — відкриту ШІ-модель для локального кодування
Thinking Machines представила модель Inkling 2 Mini з відкритими вагами, циклічною архітектурою трансформера та можливістю працювати локально на Mac без інтернету.