Modell oder Wrapper?
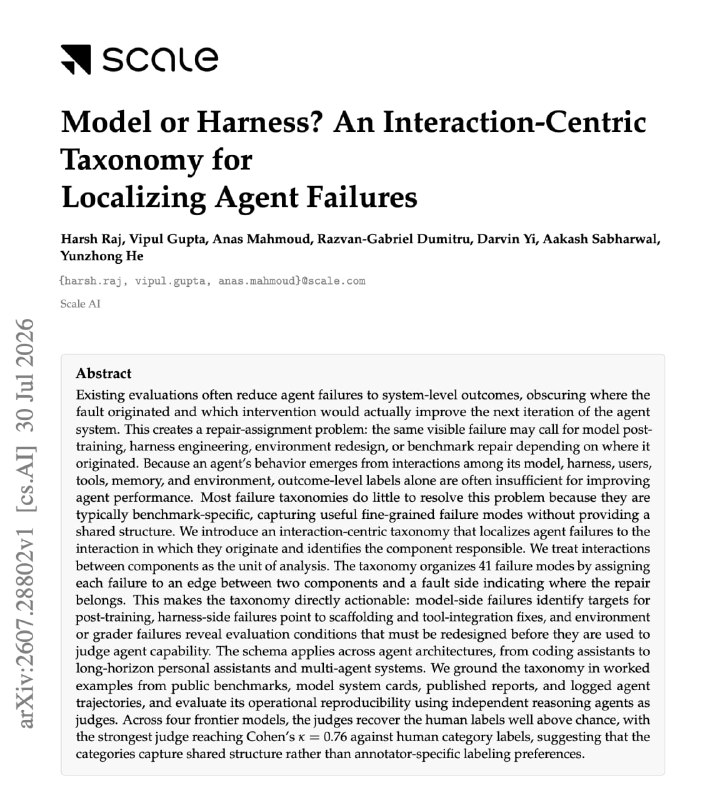
Ein neuer Forschungsansatz klassifiziert 41 typische Fehlerquellen bei KI-Agenten und betont die entscheidende Rolle der Interaktion zwischen Modell und Infrastruktur.
Modell oder Wrapper?
Wer KI-Agenten für den Produktiveinsatz entwickelt, sollte diesen Artikel auf dem Schirm haben.
Die Autoren haben 41 typische Fehler-Szenarien gesammelt und sie basierend darauf kategorisiert, an welcher Schnittstelle das Problem auftritt. Jeder Fehler wird der Interaktion zwischen dem Modell, dem Wrapper, dem Nutzer, Tools, dem Gedächtnis (Memory) oder der Umgebung zugeordnet. Dies zeigt deutlich, wo die Ursache liegt und wo korrigiert werden muss.
Dieses Vorgehen spiegelt die Realität gut wider: Die meisten Probleme mit KI-Agenten entstehen nicht im Modell selbst, sondern an der Schnittstelle zwischen dem Modell und der umgebenden Infrastruktur.
Der Ansatz eignet sich auch für automatisierte Analysen. In Tests mit vier fortschrittlichen Modellen erreichte der beste KI-Judge einen Cohen's-Kappa-Übereinstimmungskoeffizienten von 0,76 im Vergleich zur manuellen Klassifizierung. Dies ermöglicht eine automatische Fehlerklassifizierung direkt in der Produktion, anstatt nach jedem Vorfall manuell zu analysieren.
In diesem Jahr ist das sogenannte "Wrapper Engineering" zu einem der Hauptfaktoren für die Qualität von KI-Agenten geworden, doch es fehlte bisher eine gemeinsame Sprache, um Modellfehler von Wrapper-Fehlern zu trennen. Diese Arbeit bietet ein solches System.
Artikel: arxiv.org/abs/2607.28802
Warum das wichtig ist
AnalyseDer Artikel stellt einen neuen methodischen Rahmen zur Fehleranalyse in KI-Agenten vor, was die Effektivität im Produktiveinsatz signifikant steigern kann. Das Verständnis der komplexen Interaktion zwischen Modell und Wrapper ist kritisch für die Verbesserung der Gesamtqualität von KI-Lösungen.
In der Community diskutieren
Teile deine Fragen und Erkenntnisse mit Entwicklern
Verwandt im Ökosystem
Praktische Leitfäden, Terminologie und Agenten-Skills
MIT-Forschende zeigen, dass GPT-6 Astra andere KI-Modelle durch direkte Gewichtsänderungen verbessern kann
In einem Experiment erhöhte Astra die Genauigkeit von Qwen3.5-0.8B auf MATH-500 von 7,9 % auf 48,1 %, indem nur 0,016 % der Modellgewichte geändert wurden.
Autonomer KI-Operator in Telegram 24/7: Architektur, Telethon, Sicherheit und 10 funktionierende Szenarien
Umfassendes technisches Handbuch zur Erstellung eines produktionsreifen KI-Operators in Telegram auf Basis von Telethon: Sitzungsisolierung, Bestätigungssysteme, Schutz vor Bannmaßnahmen und 24/7-Betrieb.
Loop Engineering: Architektur autonomer Schleifen und das Ende des manuellen Promptings
Ein tiefgehender Einblick in Loop Engineering: Architektur selbstunterhaltender Zyklen für Claude Code und autonome Agenten, DOER/CHECKER-Muster, deterministische Verifizierung, der /goal-Befehl und die Bekämpfung von Reward Hacking.
Custom GPTs (Personalisierte Chatbots in ChatGPT)
Eine Funktion von ChatGPT zur Erstellung personalisierter Mini-Assistenten für spezifische Aufgaben. Ermöglicht das Hochladen eigener Dateien, die Festlegung permanenter Anweisungen sowie die Integration von Bildgenerierung und externen APIs ohne Programmierkenntnisse.