Modell oder Wrapper?
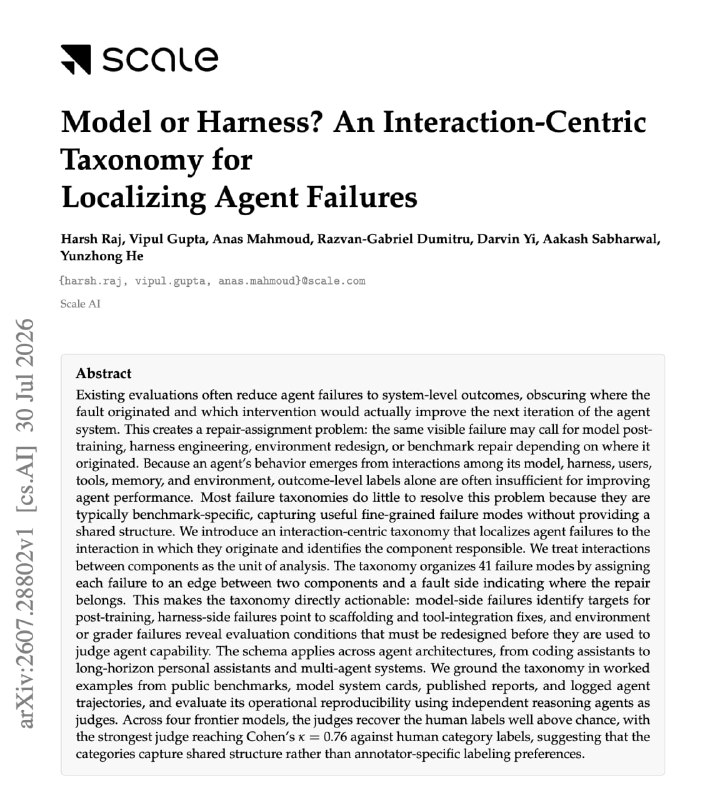
Ein neuer Forschungsansatz klassifiziert 41 typische Fehlerquellen bei KI-Agenten und betont die entscheidende Rolle der Interaktion zwischen Modell und Infrastruktur.
Modell oder Wrapper?
Wer KI-Agenten für den Produktiveinsatz entwickelt, sollte diesen Artikel auf dem Schirm haben.
Die Autoren haben 41 typische Fehler-Szenarien gesammelt und sie basierend darauf kategorisiert, an welcher Schnittstelle das Problem auftritt. Jeder Fehler wird der Interaktion zwischen dem Modell, dem Wrapper, dem Nutzer, Tools, dem Gedächtnis (Memory) oder der Umgebung zugeordnet. Dies zeigt deutlich, wo die Ursache liegt und wo korrigiert werden muss.
Dieses Vorgehen spiegelt die Realität gut wider: Die meisten Probleme mit KI-Agenten entstehen nicht im Modell selbst, sondern an der Schnittstelle zwischen dem Modell und der umgebenden Infrastruktur.
Der Ansatz eignet sich auch für automatisierte Analysen. In Tests mit vier fortschrittlichen Modellen erreichte der beste KI-Judge einen Cohen's-Kappa-Übereinstimmungskoeffizienten von 0,76 im Vergleich zur manuellen Klassifizierung. Dies ermöglicht eine automatische Fehlerklassifizierung direkt in der Produktion, anstatt nach jedem Vorfall manuell zu analysieren.
In diesem Jahr ist das sogenannte "Wrapper Engineering" zu einem der Hauptfaktoren für die Qualität von KI-Agenten geworden, doch es fehlte bisher eine gemeinsame Sprache, um Modellfehler von Wrapper-Fehlern zu trennen. Diese Arbeit bietet ein solches System.
Artikel: arxiv.org/abs/2607.28802
Warum das wichtig ist
AnalyseDer Artikel stellt einen neuen methodischen Rahmen zur Fehleranalyse in KI-Agenten vor, was die Effektivität im Produktiveinsatz signifikant steigern kann. Das Verständnis der komplexen Interaktion zwischen Modell und Wrapper ist kritisch für die Verbesserung der Gesamtqualität von KI-Lösungen.
In der Community diskutieren
Teile deine Fragen und Erkenntnisse mit Entwicklern