Dynamische Anpassung der Rechenleistung: Wie LLMs zwischen niedriger, mittlerer und hoher Inferenzintensität wechseln
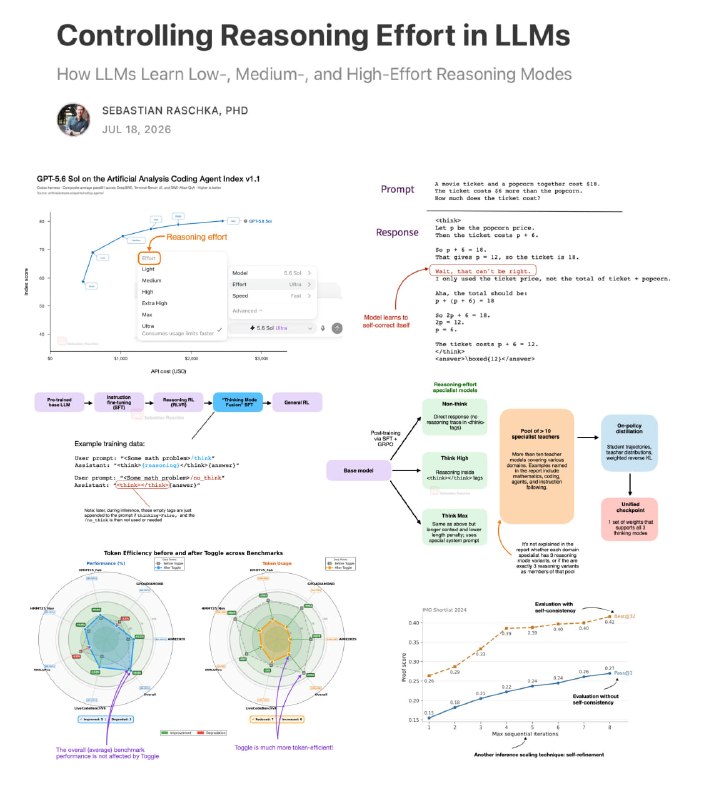
Ein neuer Ansatz zeigt, wie Large Language Models ihre Rechenkapazität während des Reasonings flexibel skalieren. Sebastian Raschka erklärt die Mechanismen hinter dieser adaptiven Tiefenkontrolle.
Dynamische Anpassung der Rechenleistung: Wie LLMs zwischen niedriger, mittlerer und hoher Inferenzintensität wechseln
Wie können Large Language Models (LLMs) zwischen niedrigen, mittleren und hohen Stufen des Rechenaufwands während des Reasonings wechseln? Und wie lernen sie, unterschiedlich tief zu argumentieren?
Sebastian Raschka hat einen kurzen Artikel verfasst, der erklärt, wie diese Aufwandsstufen sowohl während der Inferenz als auch im Training implementiert werden.
Warum das wichtig ist
Das Verständnis der Mechanismen hinter der dynamischen Anpassung des Rechenaufwands kann dazu beitragen, den Einsatz von LLMs in verschiedenen Anwendungsszenarien zu optimieren.
Warum das wichtig ist
AnalyseDie Fähigkeit zur dynamischen Skalierung des Rechenaufwands ermöglicht eine effizientere Ressourcennutzung und verbessert die Leistungsfähigkeit von LLMs bei komplexen Aufgaben ohne unnötige Kosten.
In der Community diskutieren
Teile deine Fragen und Erkenntnisse mit Entwicklern
Verwandt im Ökosystem
Praktische Leitfäden, Terminologie und Agenten-Skills
Frontier-Modelle
Die leistungsstärkste Klasse künstlicher Intelligenz an der Spitze der globalen Forschung (Claude 3.7 Sonnet, OpenAI o3/GPT-4.5, Gemini 2.0 Pro), die die Grenzen moderner Fähigkeiten in Bezug auf Reasoning, Autonomie und Coding definiert.
AI Radar: GPT-6.1 Terra, Gemini 4 Carbon, Mistral Large 4 und Preisänderungen bei OpenAI und Anthropic
Überblick über aktuelle KI-News: neue LLM-Releases, Änderungen bei OpenAI- und Anthropic-Abos, World-Modelle, Videogeneratoren und Unternehmensdetails.
MIT-Forschende zeigen, dass GPT-6 Astra andere KI-Modelle durch direkte Gewichtsänderungen verbessern kann
In einem Experiment erhöhte Astra die Genauigkeit von Qwen3.5-0.8B auf MATH-500 von 7,9 % auf 48,1 %, indem nur 0,016 % der Modellgewichte geändert wurden.
Zero-Shot CoT vs. Dynamisches Reasoning
Die historische und praktische Entwicklung von Reasoning-Techniken: von der einfachen Phrase 'Let's think step by step' (Zero-Shot Chain-of-Thought) bis zum nativen hardwareseitigen Budgeting des Denkens in modernen Modellen.