Dynamische Anpassung der Rechenleistung: Wie LLMs zwischen niedriger, mittlerer und hoher Inferenzintensität wechseln
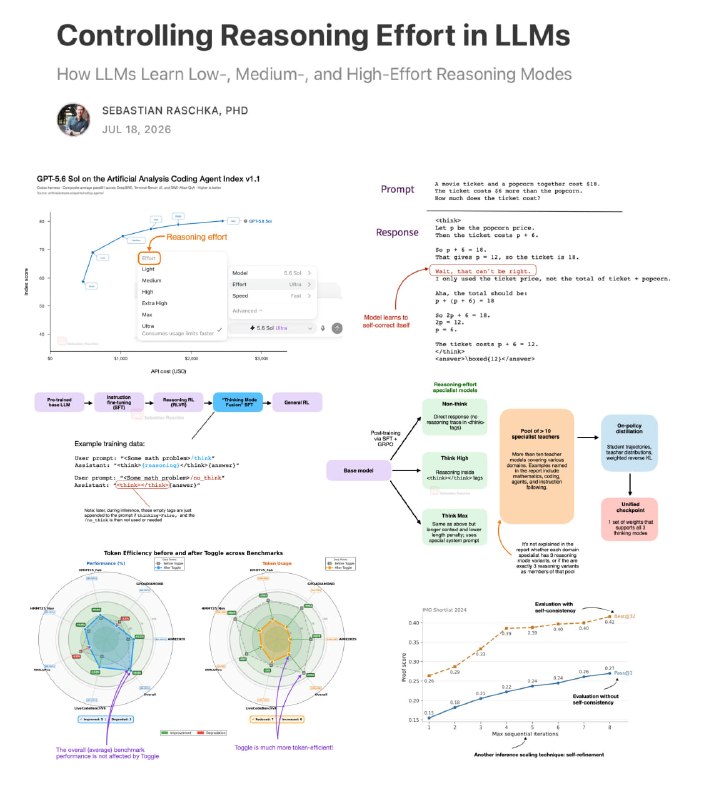
Ein neuer Ansatz zeigt, wie Large Language Models ihre Rechenkapazität während des Reasonings flexibel skalieren. Sebastian Raschka erklärt die Mechanismen hinter dieser adaptiven Tiefenkontrolle.
Dynamische Anpassung der Rechenleistung: Wie LLMs zwischen niedriger, mittlerer und hoher Inferenzintensität wechseln
Wie können Large Language Models (LLMs) zwischen niedrigen, mittleren und hohen Stufen des Rechenaufwands während des Reasonings wechseln? Und wie lernen sie, unterschiedlich tief zu argumentieren?
Sebastian Raschka hat einen kurzen Artikel verfasst, der erklärt, wie diese Aufwandsstufen sowohl während der Inferenz als auch im Training implementiert werden.
Warum das wichtig ist
Das Verständnis der Mechanismen hinter der dynamischen Anpassung des Rechenaufwands kann dazu beitragen, den Einsatz von LLMs in verschiedenen Anwendungsszenarien zu optimieren.
Warum das wichtig ist
AnalyseDie Fähigkeit zur dynamischen Skalierung des Rechenaufwands ermöglicht eine effizientere Ressourcennutzung und verbessert die Leistungsfähigkeit von LLMs bei komplexen Aufgaben ohne unnötige Kosten.
In der Community diskutieren
Teile deine Fragen und Erkenntnisse mit Entwicklern