Anthropics Fable 5.1 Max erobert den ersten Platz im Code Arena: WebDev
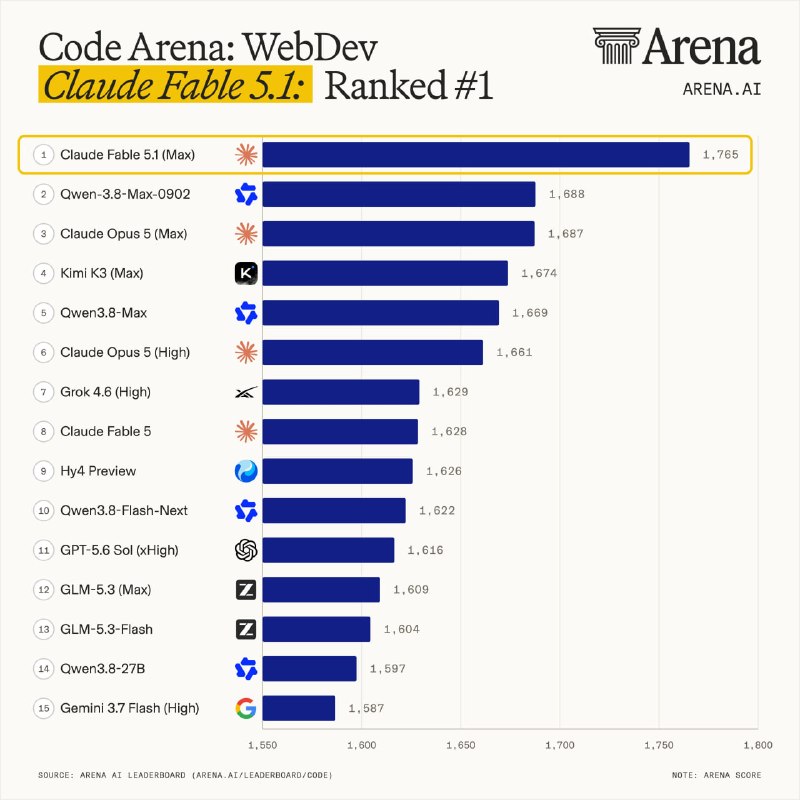
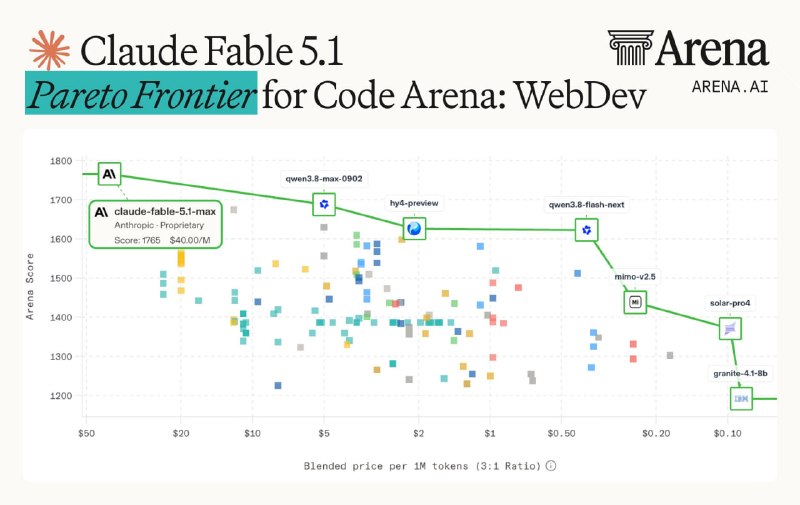
Das Modell Fable 5.1 Max von Anthropic sicherte sich mit 1765 Punkten den Spitzenplatz im Wettbewerb Code Arena: WebDev und setzte sich deutlich gegen die Konkurrenz durch.
Fable 5.1 Max von Anthropic hat den ersten Platz in der Disziplin Code Arena: WebDev errungen und dabei eine beeindruckende Punktzahl von 1765 erreicht. Dies entspricht einem Vorsprung von 77 Punkten gegenüber allen anderen Wettbewerbern.
Im Vergleich zum Vorgängermodell Fable 5 Max, das derzeit mit 1628 Punkten auf dem achten Rang liegt, stellt dies einen enormen Leistungssprung dar.
In der Gesamtwertung übertrifft Fable 5.1 Max das zweitplatzierte Modell Qwen 3.8 Max 0902 um 77 Punkte sowie Opus 5 Max auf dem dritten Platz um 78 Punkte.
Mit einer durchschnittlichen Preisgestaltung von 40 US-Dollar pro Million Tokens verschiebt das Modell auch die Pareto-Frontier im hochpreisigen Segment erheblich nach oben und setzt neue Maßstäbe für die Performance-Kosten-Effizienz.
Warum das wichtig ist
AnalyseDie Ergebnisse unterstreichen signifikante Fortschritte in der KI-Entwicklung und bestätigen die starke Marktposition des Modells. Hohe Wettbewerbswerte dienen als entscheidender Indikator für die zukünftige Relevanz und Leistungsfähigkeit von KI-Lösungen.
In der Community diskutieren
Teile deine Fragen und Erkenntnisse mit Entwicklern
Verwandt im Ökosystem
Praktische Leitfäden, Terminologie und Agenten-Skills
Claude Fable 5: Wann das leistungsstarke Modell eingesetzt wird und welcher effort-Level gewählt werden sollte
Eine vollständige Analyse des Modells Claude Fable 5 und des Parameters effort: Funktionsweise des Verhaltenssignals für Reasoning, Verfügbarkeitsmatrix der Level (low/xhigh), Kostenberechnung pro Durchlauf sowie Konfiguration in API und Claude Code.
Reddit-Nutzer erklärt, warum Claude-Code-Wochenlimits fast viermal schneller verbraucht werden
Ein Reddit-Nutzer verglich den Token-Verbrauch über zwei Wochen und stellte fest, dass auf jedes 1 % des Wochenlimits von Claude Code deutlich weniger Ausgabe-Tokens entfallen; Subagents, Reasoning-Dauer und UI-Aktualisierungen gelten als mögliche Ursachen.
Prompt-Leitfaden für GPT-Bildgenerierungsmodelle
Die Bildgenerierungsmodelle gpt-image von OpenAI sind darauf ausgelegt, Visuals in Produktionsqualität und vollständig steuerbare kreative Prozesse zu erzeugen. Sie eignen sich sowohl für professionelle Design-...
Binance veröffentlicht Untersuchung zum Diebstahl von 6,3 Mrd. US-Dollar
Die Untersuchung verbindet den Diebstahl mit einem manipulierten Homebrew, einem gefälschten Interview und dem Missbrauch eines internen KI-Tools von Binance.