Ember-1: Fine-tuning do Kimi K3 reduz o tempo de raciocínio em 40%
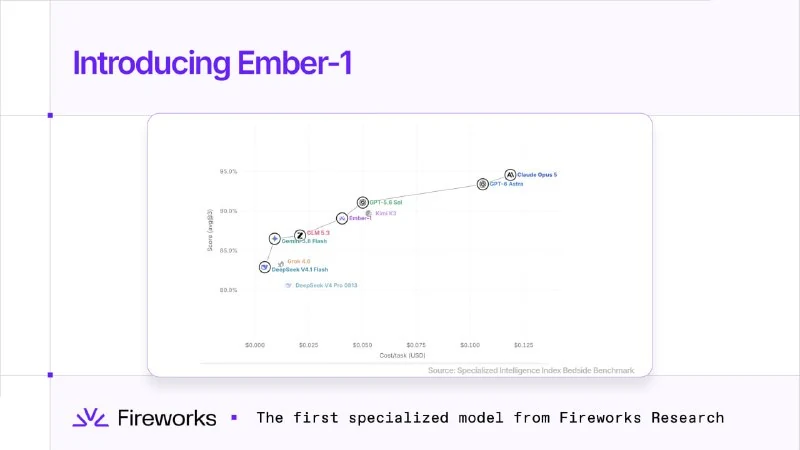
Uma equipe de pesquisa ajustou o modelo Kimi K3, encurtando seus rastros de raciocínio em cerca de 40% sem perda de qualidade. O Ember-1 já está disponível na plataforma Cline.
O Ember-1 está sendo ativamente discutido no Hacker News.
Uma equipe de pesquisa realizou o fine-tuning do Kimi K3, resultando em rastros de raciocínio aproximadamente 40% mais curtos.
A qualidade permaneceu inalterada, enquanto o modelo se tornou cerca de 40% mais rápido e econômico.
Este é um bom exemplo de como faz sentido construir LLMs de fronteira hoje. Com um orçamento de dezenas de milhões de dólares, não é necessariamente preciso treinar um novo modelo do zero. É possível adotar um modelo existente já robusto e investir esse capital no seu ajuste fino (fine-tuning).
O Ember-1 já está disponível no Cline, incluindo a nova aplicação para desktop.
Por que isso importa
AnáliseEste caso demonstra que os LLMs de fronteira podem ser aprimorados por meio do fine-tuning de modelos existentes robustos, em vez de treinamento do zero, oferecendo inferência mais rápida e econômica.
Debater na comunidade
Compartilhe suas dúvidas e insights com desenvolvedores
Relacionado no ecossistema
Guias práticos, terminologia essencial e skills de agentes
RAG vs. Fine-Tuning (O dilema eterno na implementação de IA)
Uma escolha arquitetural fundamental para empresas. RAG (busca em documentos no momento da consulta) versus Fine-Tuning (ajuste dos pesos do modelo via treinamento adicional). Critérios de decisão entre a atualização factual e um estilo comportamental específico.
Fine-Tuning
Processo de adaptação de um modelo grande já treinado para uma tarefa ou estilo específico utilizando um pequeno conjunto de dados de alta qualidade (Supervised Fine-Tuning, SFT). Permite treinar a IA em terminologia médica, tom corporativo ou formatação de código específico em poucas horas.
Parte I. Arquitetura de Agentes de IA: Blocos Fundamentais
Dez blocos fundamentais de um agente moderno: taxonomia de modelos, loop de runtime, técnicas de prompting, destilação, habilidades (skills), memória, function calling e economia por unidade.
Parte II. Arquitetura de Agentes de IA: do Modelo à Memória e Ferramentas
Imersão profunda em engenharia: tokenização, cache KV, determinismo de amostragem, stack de treinamento, quantização, engenharia de contexto, stack de segurança, RAG em produção, ReAct e sistemas swarm multiagente.