Federal Register dos EUA usa modelo chinês Qwen para busca de documentos
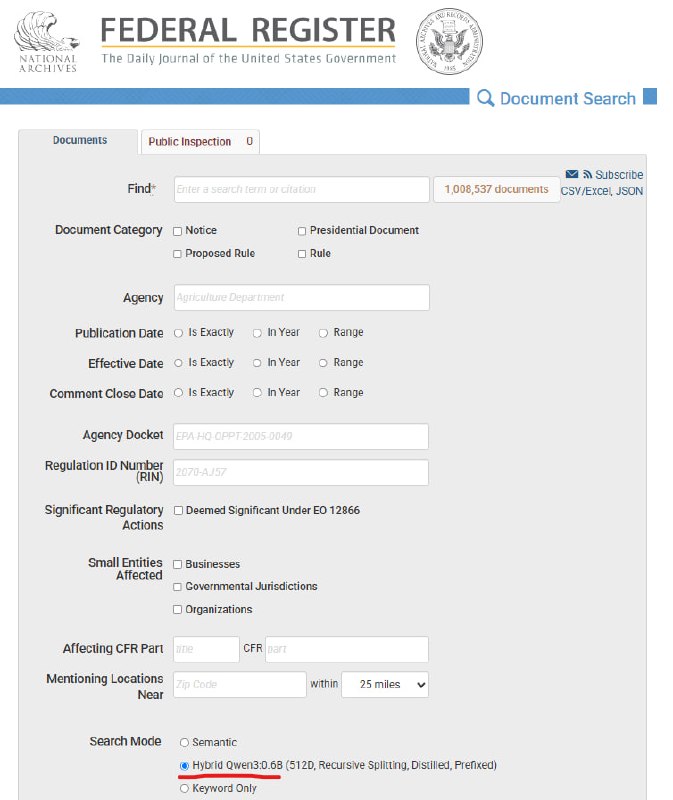
O Federal Register dos EUA emprega uma versão destilada do modelo chinês Qwen para indexar documentos governamentais, gerando ironia diante das acusações contra Pequim.
O Federal Register dos Estados Unidos está utilizando uma versão destilada do modelo de linguagem chinês Qwen para realizar buscas em documentos governamentais.
As configurações do sistema indicam explicitamente o uso de Hybrid Qwen3:0.6B Distilled.
Esta situação ganha um tom particularmente irônico no contexto das recentes acusações feitas pelos EUA contra a China por suposta "destilação de modelos em escala industrial".
Por que isso importa
AnáliseO caso evidencia a dependência global de modelos de IA open-source chineses e destaca a contradição nas tensões geopolíticas sobre roubo de tecnologia de inteligência artificial.
Debater na comunidade
Compartilhe suas dúvidas e insights com desenvolvedores
Relacionado no ecossistema
Guias práticos, terminologia essencial e skills de agentes
JSON — dados estruturados para aplicações, APIs e agentes de IA
Guia prático completo sobre o formato JSON: regras de sintaxe, serialização via parse/stringify, integração com REST API, JSON Schema e saída estruturada para inteligência artificial.
Formato CSV: Guia completo para automação e trabalho com IA
Guia prático sobre o uso do formato CSV em pipelines de IA: especificação RFC 4180, comparação com XLSX e JSON, limpeza e enriquecimento massivo de dados, codificação em Python e prompts prontos.
Sam Altman muda nome da conta no X para Ram Altman
Sam Altman, CEO da OpenAI, mudou o nome exibido da sua conta no X para Ram Altman.
Pesquisadores do MIT mostram que um LLM pode ler e editar pesos de modelos sem treinamento
O MIT CSAIL apresentou Weight-Space Programming: Astra leu e alterou os pesos do Qwen3.5-0.8B sem gradiente descendente nem fine-tuning, melhorando os resultados em benchmarks matemáticos.