arXiv wprowadza limity zgłoszeń, by ograniczyć napływ prac generowanych przez AI
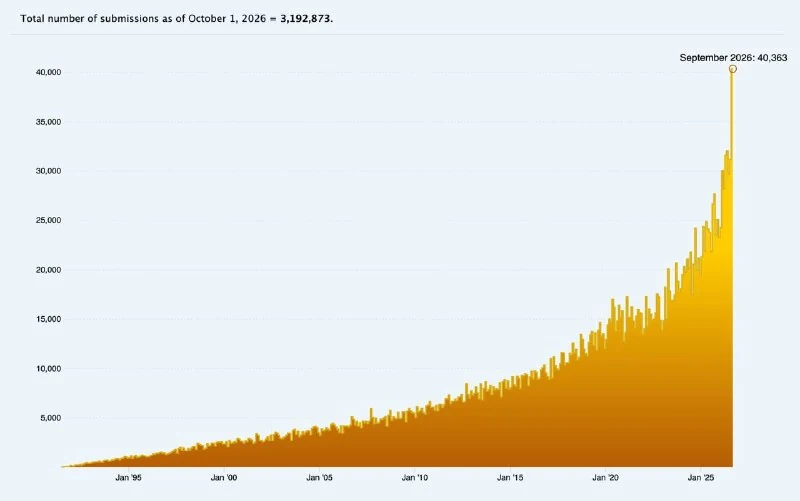
Od 1 października arXiv zezwoli użytkownikom na składanie maksymalnie dwóch prac naukowych miesięcznie, wliczając w to odrzucone zgłoszenia. Platforma tłumaczy ten krok gwałtownym wzrostem liczby manuskryptów o niskiej wartości merytorycznej oraz tych wygenerowanych przez sztuczną inteligencję.
arXiv wprowadza limit zgłoszeń prac naukowych
Od 1 października użytkownicy będą mogli składać na platformie arXiv nie więcej niż dwie prace naukowe miesięcznie. Do tego limitu wliczane są również artykuły odrzucone przez moderatorów.
Powód jest oczywisty: we wrześniu 2024 roku arXiv otrzymał 20 569 zgłoszeń, podczas gdy we wrześniu bieżącego roku liczba ta wzrosła do 40 363. Kategoria cs.AI zwiększyła się ponad sześciokrotnie w ciągu ostatnich dwóch lat.
arXiv bezpośrednio wiąże część tego wzrostu ze sztuczną inteligencją. Moderatorzy coraz częściej spotykają się z pracami o niewielkiej nowości naukowej, gdzie pojedyncze badanie jest sztucznie dzielone na kilka artykułów, a znacząca część tekstu jest generowana przez AI.
Obecne ograniczenie jest opisane jako tymczasowe: arXiv chce zrozumieć, jak powinna wyglądać moderacja publikacji naukowych w sytuacji, gdy artykuły mogą być generowane niemal bezlimitowo.
Dlaczego to ważne
AnalizaWprowadzenie limitu pokazuje, jak treści generowane przez AI wywierają presję na platformy preprintowe, zmuszając je do przemyślenia modeli moderacji naukowej. Choć może to zredukować liczbę niskiej jakości zgłoszeń, istnieje ryzyko utrudnienia publikowania rzetelnych badań przez naukowców.
Dyskutuj w społeczności
Dziel się swoimi pytaniami i spostrzeżeniami z programistami
Powiązane w ekosystemie
Praktyczne poradniki, kluczowa terminologia i skille agentów
NotebookLM + Perplexity do pracy, nauki i zarobkowania
Czym są NotebookLM i Perplexity
Format CSV: Kompletny przewodnik po automatyzacji i pracy z AI
Praktyczny poradnik dotyczący wykorzystania formatu CSV w potokach AI: specyfikacja RFC 4180, porównanie z XLSX i JSON, masowe czyszczenie i wzbogacanie danych, kodowanie w Pythonie oraz gotowe prompty.
Anthropic publikuje przewodnik po zawsze aktywnych agentach AI
Anthropic opublikował nowy przewodnik dotyczący kluczowych mechanizmów działania stale aktywnych agentów AI, w tym obsługi zdarzeń, timerów i pamięci.
CS329A: Agenci AI doskonalący się samodzielnie. Kurs Uniwersytetu Stanforda
Kurs Stanforda gromadzi wykłady i materiały dotyczące agentów AI doskonalących się samodzielnie oraz kolekcję najnowszych publikacji naukowych.