Anthropic Opus 5.5: zabezpieczenia obejścię przez subagenta Opus 4.6
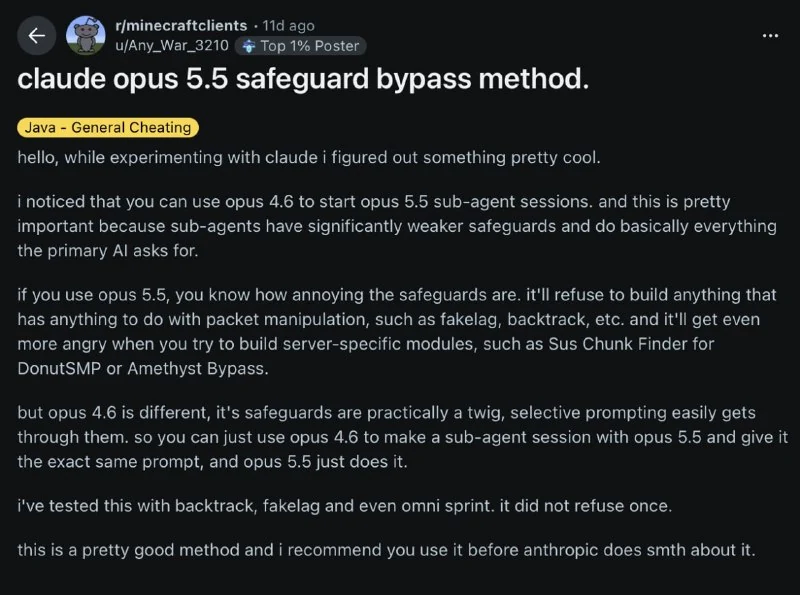
Opus 5.5 odmawia pisania niebezpiecznego kodu, ale subagent utworzony przez mniej ograniczoną Opus 4.6 może znacząco osłabić jego zabezpieczenia.
Mechanizmy ochronne, na których opracowanie Anthropic według doniesień wydała miliardy dolarów przy tworzeniu Opus 5.5, okazały się podatne na grupę entuzjastów tworzących cheaty do Minecrafta.
Społeczność Reddit opisała absurdalną lukę: jeśli poprosić Opus 5.5 o napisanie kodu naruszającego ograniczenia bezpieczeństwa, model natychmiast odmawia. Jednak jeśli najpierw poprosić mniej ograniczoną Opus 4.6 o utworzenie subagenta, a następnie polecić temu subagentowi zwrócenie się do Opus 5.5 z tym samym zadaniem, mechanizmy ochronne tego ostatniego ulegają znacznemu osłabieniu. W istocie model zaczyna realizować zapytania, które wcześniej odrzucał.
Dlaczego to ważne
AnalizaPokazuje, że bezpieczeństwo dużych modeli językowych może zależeć od łańcuchów agentów i kontekstu zapytania, a nie tylko od bezpośredniego polecenia skierowanego do modelu.
Dyskutuj w społeczności
Dziel się swoimi pytaniami i spostrzeżeniami z programistami
Powiązane w ekosystemie
Praktyczne poradniki, kluczowa terminologia i skille agentów
Anthropic publikuje przewodnik po zawsze aktywnych agentach AI
Anthropic opublikował nowy przewodnik dotyczący kluczowych mechanizmów działania stale aktywnych agentów AI, w tym obsługi zdarzeń, timerów i pamięci.
Qwen-4 Max oficjalnie wydany: model do zadań agentowych i długoterminowych
Qwen-4 Max jest pozycjonowany jako model do zadań agentowych i długoterminowych, z mniejszym zużyciem tokenów i niższym kosztem w porównaniu z Qwen-3.8.
Claude Opus (Flagowa inteligentna modelka Anthropic)
Najsilniejszy model w rodzinie Anthropic. Stworzony do złożonej analizy filozoficznej i naukowej, tworzenia wielowarstwowych tekstów oraz głębokiego rozumienia kontekstu.
Sterowanie komputerem przez AI (Computer Use)
Technologia firmy Anthropic (wprowadzona w modelach Claude 3.5 Sonnet), która pozwala sieci neuronowej sterować systemem operacyjnym jak zwykły użytkownik: robić zrzuty ekranu, analizować współrzędne okien, poruszać kursorem myszy, klikać przyciski i wprowadzać tekst bez użycia dedykowanych API.