Alibaba anuncia oficialmente a família de modelos Qwen4
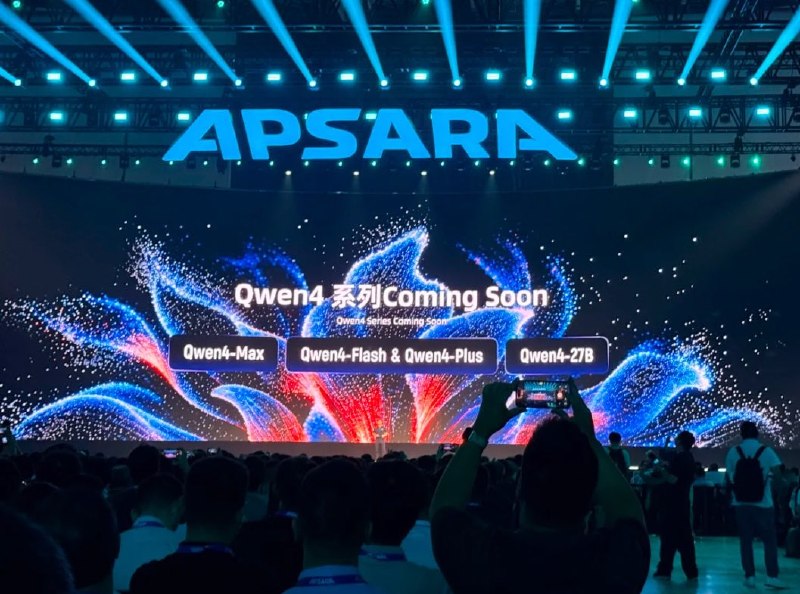
A Alibaba revelou a futura família de modelos de IA Qwen4 e apresentou o chip Zhenwu V900, que promete ser três vezes mais potente que a geração anterior.
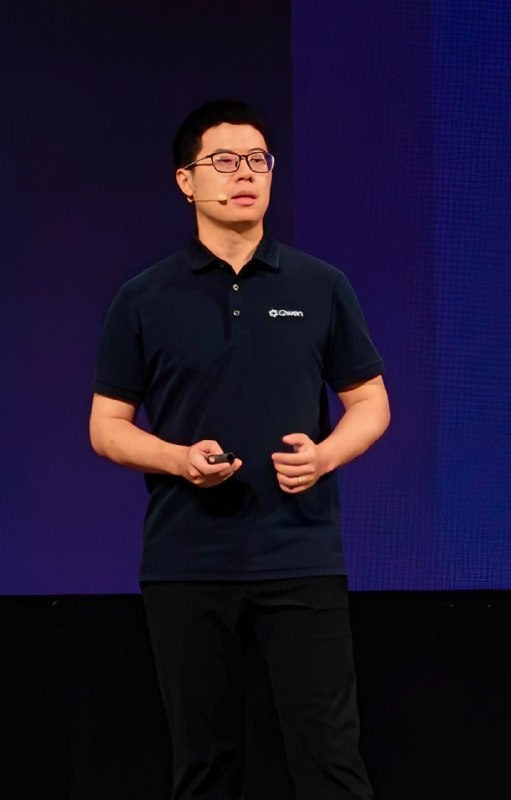
Na abertura da Conferência Cloud Intelligence 2026, Liu Daiheng, o novo líder da direção de LLMs na Qwen, anunciou oficialmente a chegada da família de modelos Qwen4.
Esta nova linha incluirá as seguintes variantes:
- Qwen4-Max
- Qwen4-Flash
- Qwen4-Plus
- Qwen4-27B
Olhando para o futuro, a Qwen pretende avançar para o treino de modelos com uma escala entre 5 e 10 biliões de parâmetros.
Em paralelo, a Alibaba apresentou o chip de IA Zhenwu V900, que, segundo a empresa, é três vezes mais poderoso do que a sua geração anterior. Com base neste hardware, a companhia planeia construir clusters com até 500.000 aceleradores. Além disso, prevê-se que a capacidade dos centros de dados da Alibaba cresça para 20 GW até 2032.
Por que isso importa
AnáliseO anúncio do Qwen4 e do novo chip confirma os planos ambiciosos da Alibaba no domínio dos grandes modelos de linguagem e da infraestrutura de IA proprietária.
Debater na comunidade
Compartilhe suas dúvidas e insights com desenvolvedores
Relacionado no ecossistema
Guias práticos, terminologia essencial e skills de agentes
Modelos de Fronteira
A classe mais poderosa de inteligência artificial na vanguarda da pesquisa global (Claude 3.7 Sonnet, OpenAI o3/GPT-4.5, Gemini 2.0 Pro), que define os limites atuais das capacidades de raciocínio, autonomia e codificação.
Alibaba Qwen (Líder em código aberto e matemática)
Série de modelos de alto desempenho de código aberto da divisão de nuvem da Alibaba (Qwen 2.5, Qwen Coder). Reconhecido líder entre os modelos abertos em geração de código, matemática e processamento multilíngue.
Thinking Machines lança Inkling 2 Small: modelo MoE de 594B que pode treinar outros modelos
A Thinking Machines apresentou o Inkling 2 Small, um modelo MoE de 594B parâmetros que lidera entre modelos abertos em várias tarefas e demonstrou poder fazer fine-tuning do Qwen3.5-4B de forma autônoma.
Revolut move cerca de 2.000 engenheiros para modelos GLM locais para programação
A Revolut migrou cerca de 2.000 engenheiros para modelos GLM implantados localmente, reduzindo o custo de codificação com IA em cerca de dez vezes e o tempo de execução das tarefas em 70%.