Novo benchmark surge sem detalhes técnicos divulgados
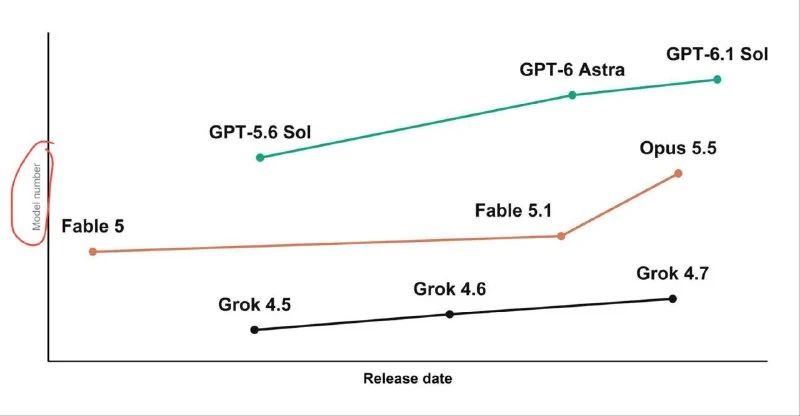
Um novo benchmark de IA surgiu online, mas carece de informações essenciais sobre o modelo ou métricas. A ausência de dados impede qualquer avaliação inicial da sua relevância.
Um novo benchmark apareceu recentemente sem a divulgação de detalhes fundamentais.
A publicação não inclui links para repositórios, artigos científicos, modelos específicos ou definições de métricas. Consequentemente, a sua relevância e fiabilidade ainda não podem ser avaliadas pela comunidade técnica.
Por que isso importa
AnáliseEmbora os benchmarks sejam cruciais para monitorizar o progresso da IA, a falta de fontes transparentes e métricas claras torna impossível avaliar a qualidade do teste.
Debater na comunidade
Compartilhe suas dúvidas e insights com desenvolvedores
Relacionado no ecossistema
Guias práticos, terminologia essencial e skills de agentes
Claude Sonnet 4.6 vs GPT-5.5 vs Gemini 3.1 Pro: Comparação de Modelos 2026
A cada poucas semanas, surge um novo modelo, e sempre as mesmas perguntas: vale a pena migrar? O que mudou? Pelo que pagar?
GPT-6.2 Astra: mais exemplos de geração 3D
O GPT-6.2 Astra mostra cenas 3D, incluindo recriações de Vice City e Rick Astley, enquanto prompts complexos podem consumir rapidamente os limites de assinatura.
Benchmarks para agentes: GAIA e SWE-bench
Nova geração de benchmarks práticos rigorosos para avaliar a autonomia da inteligência artificial. O GAIA testa tarefas multimodais na web aberta, envolvendo arquivos e navegador, enquanto o SWE-bench verifica a capacidade dos agentes de encontrar e corrigir bugs reais em grandes repositórios do GitHub.
Avaliações de Agentes e Benchmarking SWE-bench
Metodologia e infraestrutura para a medição sistemática da confiabilidade, precisão e segurança de agentes de IA por meio de testes sintéticos, SWE-bench e simulações headless de repositórios.