Kimi K3.1 y DeepSeek V4.1 Flash habrían sido destilados de Astra
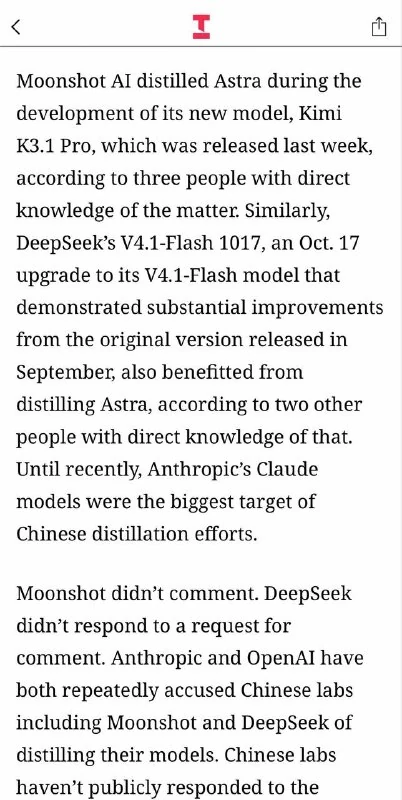
The Information afirma que Kimi K3.1 y DeepSeek V4.1 Flash podrían haberse creado mediante destilación desde Astra, un modelo asociado con OpenAI.
The Information informa de que Kimi K3.1, un modelo chino recién lanzado, supuestamente fue destilado a partir de Astra, un modelo asociado con OpenAI.
La misma publicación afirma que un enfoque similar podría haberse utilizado en el nuevo checkpoint DeepSeek V4.1 Flash.
Por qué importa
- La destilación de modelos de IA entrena un modelo más pequeño a partir de las salidas o estados ocultos de uno más grande.
- Si se confirma, Astra podría ser una fuente clave de conocimiento para los laboratorios chinos de IA.
- El caso muestra cómo la transferencia de capacidades puede reconfigurar la competencia entre grandes ecosistemas de IA.
Por qué es importante
AnálisisSi se confirma, el caso muestra cómo la destilación puede acelerar la transferencia de capacidades entre ecosistemas de IA y abre debates sobre el origen y los límites del entrenamiento de modelos.
Debatir en la comunidad
Comparte tus preguntas e ideas con desarrolladores
Relacionado en el ecosistema
Guías prácticas, terminología y skills de agentes
DeepSeek V4.1 Flash ya está disponible en Cursor
DeepSeek V4.1 Flash ya está disponible en Cursor; según los resultados de CursorBench, una tarea cuesta entre $0,60 y $0,98, lo que hace el modelo atractivo para el trabajo diario con código.
DeepSeek (Ruptura China en IA Abierta)
Serie de modelos abiertos innovadores de la laboratorio chino DeepSeek (V3, R1). Demuestra el más alto nivel en codificación y razonamiento a un costo de 10 a 20 veces inferior al de los análogos comerciales occidentales.
Cómo ejecutar LLMs locales: guía de instalación, modelos y optimización
Guía completa para ejecutar modelos de lenguaje en local: requisitos de hardware, despliegue de Ollama y Open WebUI, comparativa de Llama 3, Qwen 2.5, DeepSeek y cuantización GGUF.
RLVR (Reinforcement Learning with Verifiable Rewards)
Método de post-entrenamiento y optimización del razonamiento de agentes de IA, donde la función de recompensa se basa en verificaciones matemáticas objetivas, compiladores y pruebas unitarias en lugar de evaluaciones humanas subjetivas.