Apoyo a Modelos de IA Abiertos por Empresas Líderes
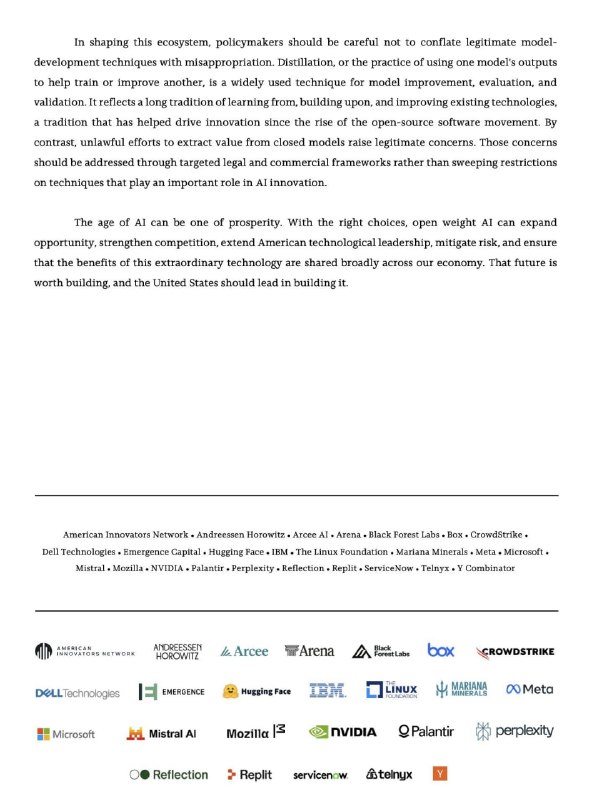
Empresas prominentes han firmado una carta abierta en apoyo a modelos de IA con pesos abiertos, enfatizando la importancia de su apertura para la competencia y la seguridad.
NVIDIA, Microsoft, Mozilla, Linux Foundation y otras empresas y organizaciones han firmado una carta abierta en apoyo a modelos con pesos abiertos.
Subrayan que la apertura de la IA es una condición CLAVE para fomentar la competencia, reducir costos, disminuir la dependencia de unas pocas grandes empresas y mejorar la seguridad.
Otro punto importante es que utilizar las respuestas de un modelo para entrenar a otro mediante destilación es una práctica legítima y común. No debe considerarse automáticamente como robo.
Por qué es importante
AnálisisEsto es importante porque la apertura de los modelos de IA puede fomentar la innovación y reducir la monopolización del mercado.
Debatir en la comunidad
Comparte tus preguntas e ideas con desarrolladores
Relacionado en el ecosistema
Guías prácticas, terminología y skills de agentes
JSON — Datos estructurados para programas, APIs y agentes de IA
Guía práctica y completa sobre JSON: especificación de sintaxis, serialización con parse y stringify, consumo de APIs REST, validación con JSON Schema y salidas estructuradas para LLMs.
Formatos DOCX y XLSX: cuándo se necesita un documento final completo de la IA
Guía práctica y completa sobre la generación y procesamiento de documentos DOCX y libros XLSX con IA: comparativa con Markdown y CSV, ingeniería de prompts, fórmulas y automatización en código.
Monopolio de Nvidia y la Plataforma CUDA
Análisis del dominio tecnológico y económico de Nvidia en el mercado de inteligencia artificial. La plataforma CUDA (Compute Unified Device Architecture), creada en 2006, transformó las tarjetas gráficas de juegos en la principal herramienta computacional del planeta, dificultando a los competidores (AMD, Intel) romper esta monopolio.
Motores de Alta Velocidad TensorRT-LLM y SGLang
Motores computacionales profundamente compilados para la optimización extrema del inferencia de modelos de lenguaje en servidores NVIDIA, con optimización de gráficos, FlashAttention-3 y enrutamiento avanzado.