Google und DeepMind stellen Dream-RSI vor: Ein rekursiver Selbstverbesserungs-Loop für KI-Agenten
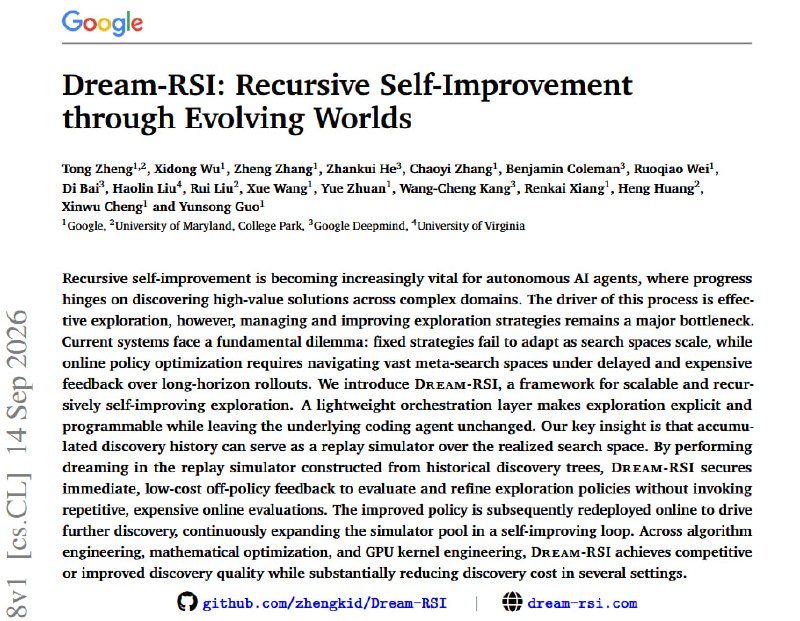
Forscher von Google und DeepMind haben Dream-RSI entwickelt, ein System, das die Erkundungsstrategien von KI-Agenten durch das Nachspielen früherer Versuche und das Testen alternativer Ansätze optimiert. Der Ansatz verbesserte Ergebnisse in Algorithmusdesign und mathematischer Optimierung, während die Suchkosten um bis zu 162-fach gesenkt wurden.
Forscher von Google und DeepMind haben Dream-RSI vorgestellt, ein System, in dem ein KI-Agent seine Methode zur Aufgabenbearbeitung kontinuierlich verbessert. Dabei spielt der Agent frühere Versuche nach, testet kostengünstig Tausende von alternativen Strategien und wählt für die nächste Runde die erfolgreichsten aus.
In Aufgabenbereichen wie der Entwicklung von Algorithmen, der mathematischen Optimierung und der Erstellung von GPU-Kernels konnte das System die Qualität der Ergebnisse beibehalten oder sogar steigern, während die Suchkosten erheblich reduziert wurden. In einem Experiment sank die Anzahl der Agent-Aufrufe um den Faktor 162.
Entscheidend ist, dass das System die Erkundungsstrategie selbst optimiert und nicht die Gewichte des Modells.
Das Fachpapier ist auf arXiv verfügbar: https://arxiv.org/pdf/2609.14858.
Warum das wichtig ist
AnalyseDies demonstriert einen Weg zu effektiverer KI, indem der Forschungsprozess optimiert wird, anstatt sich nur auf die Skalierung von Modellgewichten zu verlassen. Das könnte agentische Aufgaben bei komplexen ingenieurwissenschaftlichen und mathematischen Problemen deutlich günstiger und schneller machen.
In der Community diskutieren
Teile deine Fragen und Erkenntnisse mit Entwicklern