Astra нібито стала ключовою моделлю для дистилляції в китайських ШІ-лабораторіях
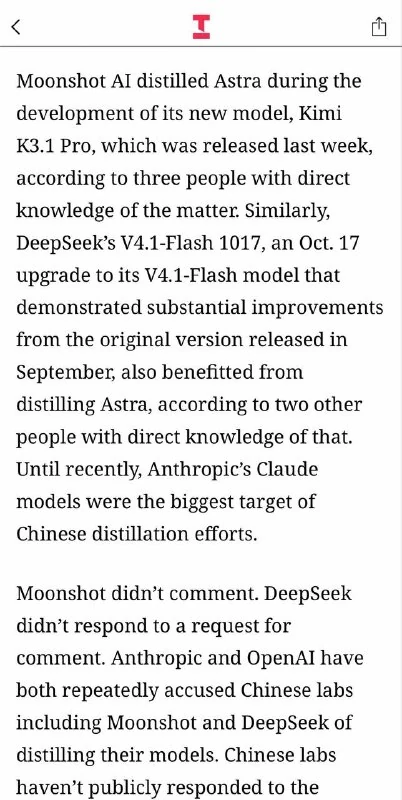
The Information стверджує, що китайські моделі Kimi K3.1 і DeepSeek V4.1 Flash нібито були створені шляхом дистилляції з Astra, пов’язаної з OpenAI.
The Information стверджує, що нещодавно випущена китайська модель Kimi K3.1 нібито була дистильована з Astra — моделі, пов’язаної з OpenAI.
У тій же публікації стверджується, що аналогічний підхід міг бути застосований до нового чекпоінта DeepSeek V4.1 Flash.
Що означає цей сигнал
- Дистилляція ШІ-моделей — це навчання меншої моделі на виводах або прихованих станах більшої та потужнішої моделі.
- Якщо твердження підтвердяться, Astra може бути одним із важливих «донорів» знань для китайських ШІ-лабораторій.
- Це вказує на швидкий обмін технологічними можливостями між найбільшими ШІ-екосистемами.
Чому це важливо
АналітикаЯкщо твердження підтвердиться, це покаже, як дистилляція може прискорювати передачу можливостей між великими ШІ-екосистемами та загострить дискусію про межі навчання моделей.
Обговорити новину у спільноті
Діліться своїм досвідом та думками з ШІ-розробниками
Пов'язані матеріали екосистеми
Практичні гайди, термінологія та агентські скіли
DeepSeek V4.1 Flash стала доступна в Cursor
DeepSeek V4.1 Flash з’явилася в Cursor; за результатами CursorBench вартість виконання одного завдання становить $0,60–$0,98, що робить модель привабливою для повсякденної роботи з кодом.
Як запустити локальну LLM: налаштування, моделі та оптимізація
Повний посібник із запуску локальних нейромереж на власному ПК: апаратні вимоги, розгортання Ollama і Open WebUI, огляд Llama 3, Qwen 2.5, DeepSeek та квантування GGUF.
RLVR (Reinforcement Learning with Verifiable Rewards)
Метод пост-тренінгу та оптимізації міркувань ШІ-агентів, де функція винагороди базується на об'єктивних математичних перевірках, компіляторах та юніт-тестах замість суб'єктивних людських оцінок.
Context Distillation & Token Squeezing
Методи автоматичного видалення надлишкових слів, синтаксичного шуму, форматувальних пробілів та застарілих повідомлень перед відправкою промпту в модель для економії бюджету та прискорення інференсу.