OpenAI prezentuje GPT-6 Sol i Luna: obniżki cen i ulepszone mechanizmy cache
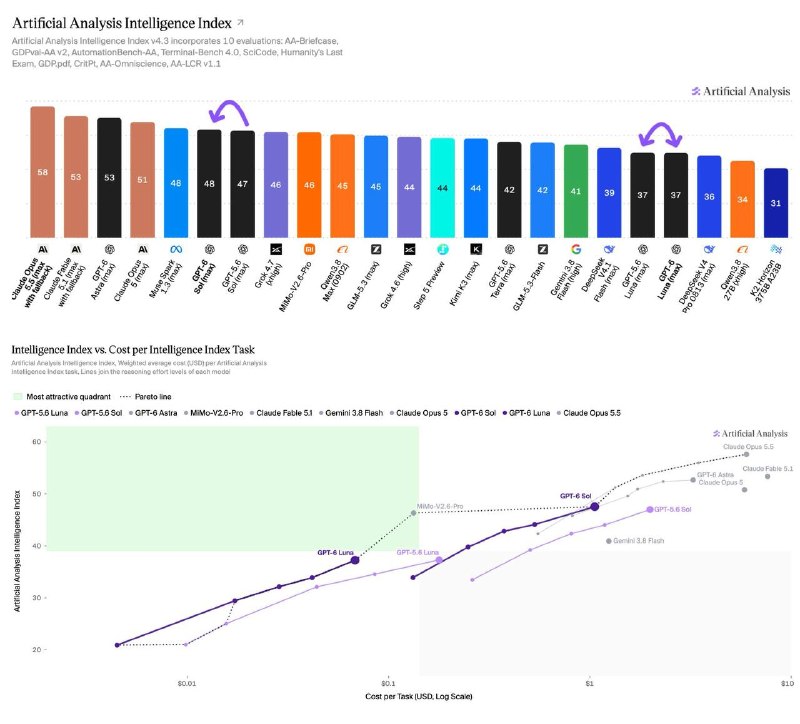
OpenAI wprowadza nowe modele GPT-6 Sol i Luna, znacząco redukując koszty operacyjne i usprawniając system cache. Sol konkuruje z Claude Fable 5.1 w zadaniach kodowania, oferując przy tym znacznie niższą cenę.
OpenAI zaprezentowało swoje nowe modele, GPT-6 Sol i Luna, kontynuując trend obniżek cen zapoczątkowany wcześniej przez Anthropic.
Zmiany w cenniku
Koszty korzystania z nowych modeli zostały istotnie skorygowane:
- Sol: Ceny zostały obniżone o połowę.
- Luna: Spadek cen wyniósł około 50–58%.
Wydajność w kodowaniu
Według benchmarków, model Sol nie ustępuje nowemu Opusowi w zadaniach związanych z kodowaniem. Jego wskaźniki są porównywalne z Claude Fable 5.1:
- W teście FrontierCode Sol dorównuje wersji Claude Fable 5.1 xhigh.
- W teście DeepSWE Sol osiąga wynik 68,8%, podczas gdy Fable 5 uzyskuje 69,9%. Jednakże Sol jest około 80% tańszy.
- Luna (w trybie max) osiąga 66,6%, co plasuje ją na poziomie Opus 5 oraz Fable 5 (medium), ale przy kosztach niższych o 93–96%.
Ulepszenia systemu cache
OpenAI znacząco udoskonaliło swój system buforowania:
- Wyższy wskaźnik trafień (hit rate).
- Rabat na dane wejściowe z cache wynosi obecnie 90%.
- Dodano narzędzia do panelu zarządzania i diagnostyki.
- Cache nie resetuje się już przy zmianie parametru
reasoning effortani przy włączaniu/wyłączaniu narzędzi.
Dostępność
Modele są już dostępne w ramach subskrypcji oraz poprzez API. Luna jest również oferowana bezpłatnie.
Dlaczego to ważne
AnalizaObniżki cen i ulepszenia cache zwiększają dostępność zaawansowanych modeli AI OpenAI dla deweloperów, a konkurencyjna wydajność w kodowaniu wywiera presję na inne laboratoria badawcze.
Dyskutuj w społeczności
Dziel się swoimi pytaniami i spostrzeżeniami z programistami
Powiązane w ekosystemie
Praktyczne poradniki, kluczowa terminologia i skille agentów
GPT-6 Astra: przewodnik po nowym modelu OpenAI
Pełny przegląd flagowego modelu GPT-6 Astra: architektura agentowa, możliwości Computer Use, kodowanie w Codex, benchmarki cyberbezpieczeństwa, niuanse promptowania oraz przewodnik po migracji API.
Kaszowanie promptów (Prompt Caching & KV Cache Reuse)
Technologia stosowana w nowoczesnych silnikach inferencyjnych oraz chmurowych API (Anthropic, OpenAI, DeepSeek, vLLM), która przechowuje wcześniej obliczone macierze uwagi (KV Cache) dla statycznego prefiksu, zmniejszając koszty przetwarzania o 80–90% oraz skracając czas do pierwszego tokenu (TTFT) czterokrotnie do ośmiokrotnie.
OpenAI GPT (Flagowe modele z serii GPT)
Główna, uniwersalna linia dużych modeli językowych od OpenAI (GPT-4, GPT-4o). Optymalizowana pod kątem złożonej analizy tekstu, programowania, kreatywności oraz codziennej pracy intelektualnej.
OpenAI dodaje obsługę wychodzących połączeń telefonicznych w API GPT-Live
OpenAI oficjalnie dodała obsługę wychodzących połączeń SIP w API GPT-Live, umożliwiając tworzenie głosowych agentów AI, którzy dzwonią w czasie rzeczywistym.