Sand.ai veröffentlicht Open-MoE-Videomodell MAGI-2 Preview
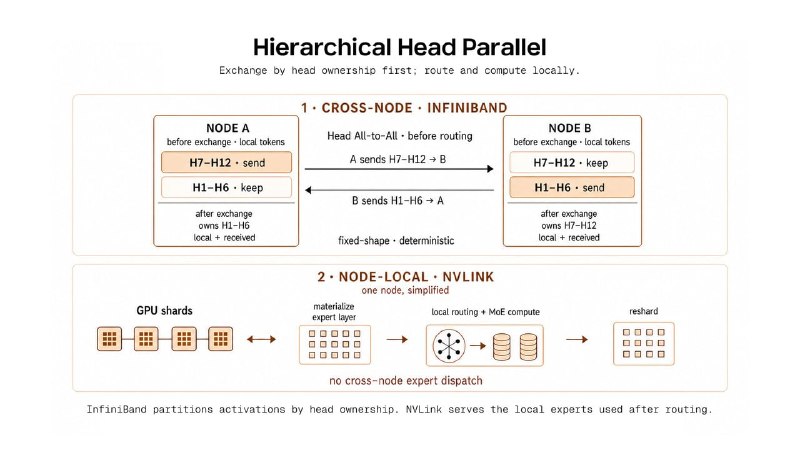
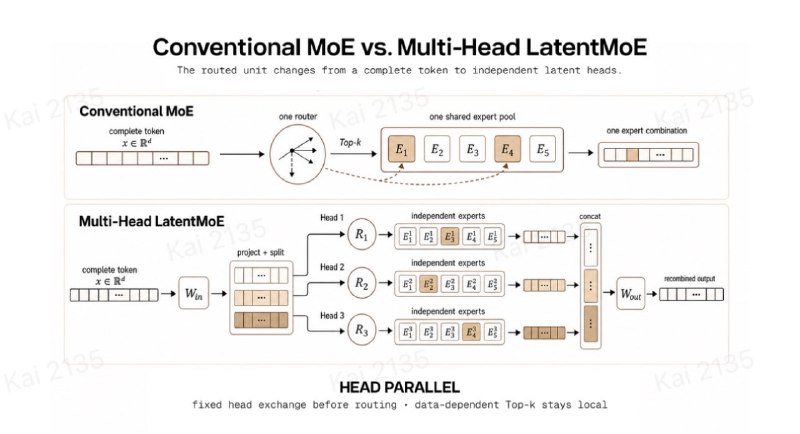
Sand.ai hat die Gewichte und den Inferenzcode für das neue Videomodell MAGI-2 Preview freigegeben, das synchronisierte Audio generiert. Das Modell nutzt eine seltene feingranulare Mixture-of-Experts-Architektur (MoE), um die Rechenkosten drastisch zu senken.
Sand.ai veröffentlicht Open-MoE-Videomodell MAGI-2 Preview
Entwickler von Sand.ai haben die Gewichte und den Inferenzcode für das Modell MAGI-2 Preview veröffentlicht. Das Modell basiert auf einer Single-Stream-Architektur und erzeugt 10-sekündige Videoclips inklusive synchronisierter Audiospuren.
Es setzt auf eine für solche Modelle ungewöhnliche, feingranulare Mixture-of-Experts (MoE)-Struktur. Bei insgesamt 114 Milliarden Parametern werden pro Token nur 6 Milliarden aktiviert. In Bezug auf den Rechenaufwand pro Schritt ist es deutlich leichter als das dichte MiniMax H3 (33B). Dies führt zu einer Reduzierung der Inferenzkosten um etwa das Zehnfache, und das Modell hat sich auf Platz 6 des Artificial Analysis Leaderboards geschoben.
Der Generierungsprozess verläuft in zwei Stufen: Zunächst erzeugt das Basismodell das Video in niedriger Auflösung, anschließend skaliert ein Refiner das Ergebnis auf 1080p hoch.
Aktuell kann MAGI-2 noch nicht mit MiniMax H3 hinsichtlich der lokalen Verfügbarkeit konkurrieren. Während das quantisierte H3 auf einer einzelnen 24GB-Grafikkarte (RTX 3090/4090) läuft, benötigt MAGI-2 erheblich mehr Ressourcen. Für Cloud-Anbieter wird die Inferenz über API jedoch aufgrund der lediglich 6 Milliarden aktiven Parameter deutlich günstiger sein, und diese Architektur bietet gutes Skalierungspotenzial.
Warum das wichtig ist
AnalyseDieses Modell eröffnet neue Möglichkeiten für die Generierung von Videos mit synchronisiertem Audio bei gleichzeitig stark reduzierten Inferenzkosten. Die innovative MoE-Architektur zeigt zudem erhebliches Potenzial für weitere Entwicklung und Skalierung im Bereich der KI-gestützten Medienproduktion.
In der Community diskutieren
Teile deine Fragen und Erkenntnisse mit Entwicklern
Verwandt im Ökosystem
Praktische Leitfäden, Terminologie und Agenten-Skills
Thinking Machines veröffentlicht Inkling 2 Small: ein 594B-MoE-Modell, das andere Modelle feinabstimmen kann
Thinking Machines hat Inkling 2 Small vorgestellt, ein MoE-Modell mit 594B Parametern, das unter offenen Modellen in mehreren Benchmarks führt und autonom Qwen3.5-4B feinabstimmen konnte.
Binance veröffentlicht Untersuchung zum Diebstahl von 6,3 Mrd. US-Dollar
Die Untersuchung verbindet den Diebstahl mit einem manipulierten Homebrew, einem gefälschten Interview und dem Missbrauch eines internen KI-Tools von Binance.
Prompt-Leitfaden für GPT-Bildgenerierungsmodelle
Die Bildgenerierungsmodelle gpt-image von OpenAI sind darauf ausgelegt, Visuals in Produktionsqualität und vollständig steuerbare kreative Prozesse zu erzeugen. Sie eignen sich sowohl für professionelle Design-...
Claude Sonnet 4.6 vs GPT-5.5 vs Gemini 3.1 Pro: Modellvergleich 2026
Alle paar Wochen erscheint ein neues Modell, und jedes Mal stellen sich dieselben Fragen: Lohnt sich der Wechsel? Was hat sich geändert? Wofür lohnt sich die Investition?