Modelos chineses abertos mostram indícios de treinamento em GPUs Blackwell restritas à exportação
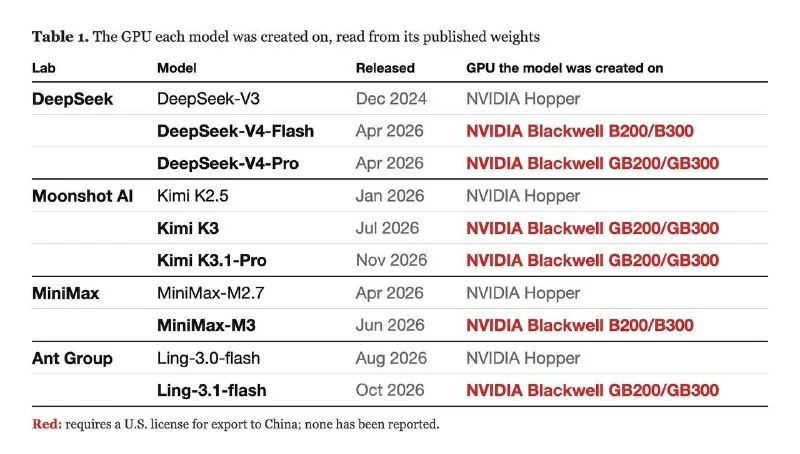
Pesquisadores independentes afirmam ter encontrado nos pesos de vários modelos chineses abertos sinais de treinamento com GPUs Blackwell, cuja exportação para a China é restrita.
Segundo os pesquisadores, os pesos de modelos abertos podem reter uma impressão digital da GPU na qual foram gerados pela primeira vez. Os valores iniciais dependem do seed e do chip específico, e parte desse padrão pode sobreviver ao treinamento.
A análise teria examinado cerca de seis trilhões de combinações de chips e seeds e encontrado correspondências em seis modelos de quatro laboratórios chineses:
- DeepSeek-V4-Flash e MiniMax-M3 teriam sido treinados em B200 ou B300.
- DeepSeek-V4-Pro, Kimi K3, Kimi K3.1-Pro e Ling-3.1-flash teriam sido treinados em GB200 ou GB300.
Modelos anteriores dos mesmos laboratórios, segundo a metodologia, aparentam ter sido treinados em Hopper.
O autor também afirma que Kimi K3 e DeepSeek-V4-Pro podem ter usado de 2 mil a 3 mil GPUs Blackwell cada. Um cluster dessa escala custa cerca de US$ 200 milhões.
O autor diz que pesquisadores da OpenAI e da Anthropic verificaram os resultados. Se confirmado, os laboratórios chineses podem enfrentar sanções graves.
Por que isso importa
AnáliseSe a alegação se confirmar, o hardware de treinamento pode ser identificável nos pesos do modelo, reforçando o controle sobre restrições de exportação.
Debater na comunidade
Compartilhe suas dúvidas e insights com desenvolvedores
Relacionado no ecossistema
Guias práticos, terminologia essencial e skills de agentes
Guia de prompts para modelos generativos GPT Image
Os modelos de geração de imagens gpt-image da OpenAI foram criados para obter visuais de qualidade de produção e processos criativos totalmente controláveis. São adequados tanto para design profissional...
Claude Sonnet 4.6 vs GPT-5.5 vs Gemini 3.1 Pro: Comparação de Modelos 2026
A cada poucas semanas, surge um novo modelo, e sempre as mesmas perguntas: vale a pena migrar? O que mudou? Pelo que pagar?
RLVR (Reinforcement Learning with Verifiable Rewards)
Método de pós-treinamento e otimização do raciocínio de agentes de IA, onde a função de recompensa é baseada em verificações matemáticas objetivas, compiladores e testes unitários, em vez de avaliações humanas subjetivas.
Descarregamento e Compressão do KV-Cache
Métodos de hardware e algoritmos para o descarregamento temporário do cache de chaves e valores (KV-Cache) da memória de vídeo GPU, de alto custo, para a memória RAM do sistema ou SSDs NVMe rápidos.