Meta lanza Muse Spark 1.3 — Un modelo de alto rendimiento
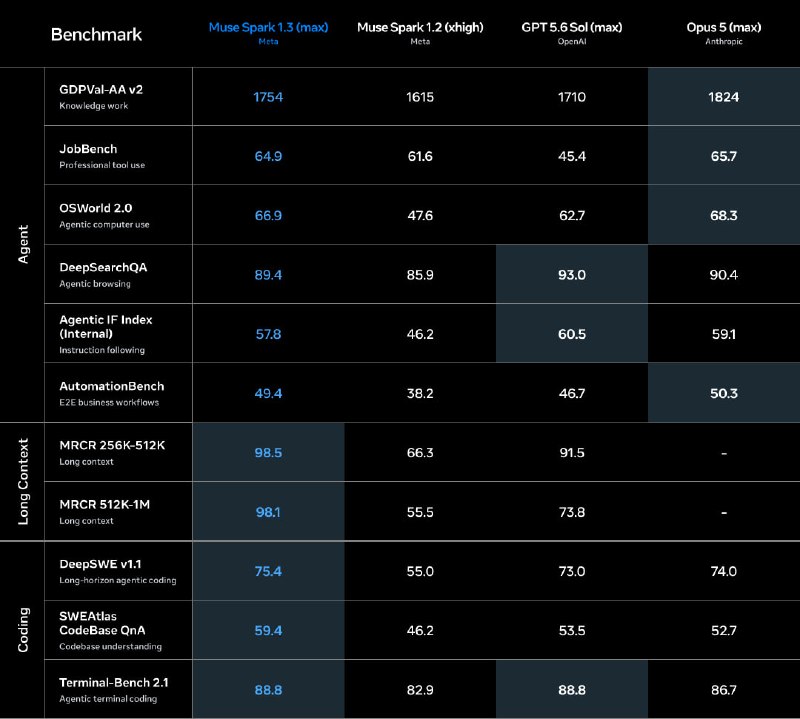
Meta ha presentado Muse Spark 1.3, un modelo que muestra un rendimiento impresionante a un precio asequible.
Meta lanza Muse Spark 1.3
El modelo Muse Spark 1.3 de Meta demuestra un rendimiento comparable al de los modelos líderes, manteniendo un precio casi simbólico.
Esta vez, el lanzamiento se realizó sin previo aviso. Muse Spark 1.3 apareció primero en Meta API y OpenCode, y solo luego la compañía publicó los resultados de las pruebas.
En Terminal-Bench 2.1, el modelo obtuvo una puntuación de 88.8, igualando a GPT-5.6 Sol. En DeepSWE, logró un 75.4%, colocándolo entre los modelos más fuertes para programación. Los resultados en otras pruebas también son bastante impresionantes.
Muse Spark 1.3 ya está disponible en Muse Code y a través de API.
Zuckerberg también insinuó que el próximo gran lanzamiento será Watermelon, y se promete que los pesos abiertos de Muse Spark se lanzarán pronto.
Por qué es importante
AnálisisEste modelo podría tener un impacto significativo en el desarrollo de tecnologías de inteligencia artificial al ofrecer un alto rendimiento a un precio asequible.
Debatir en la comunidad
Comparte tus preguntas e ideas con desarrolladores
Relacionado en el ecosistema
Guías prácticas, terminología y skills de agentes
Guía de prompts para los modelos generativos GPT Image
Los modelos de generación de imágenes gpt-image de OpenAI están diseñados para obtener visuales de calidad de producción y procesos creativos totalmente controlables. Son adecuados...
Claude Sonnet 4.6 vs GPT-5.5 vs Gemini 3.1 Pro: comparación de modelos 2026
Cada pocas semanas sale un nuevo modelo y cada vez surgen las mismas preguntas: ¿debería cambiar? ¿Qué cambió por qué pagar?
Familia Llama (Meta Llama)
Serie de modelos de lenguaje fundamentales y abiertos de Meta (Llama 3, 3.1, 3.3) que se han convertido en el estándar industrial de la ecosistema Open Weights, IA local y fine-tuning corporativo.
Investigadores del MIT muestran que GPT-6 Astra puede mejorar otros modelos de IA cambiando sus pesos
En un experimento, Astra elevó la precisión de Qwen3.5-0.8B en MATH-500 del 7,9% al 48,1% cambiando solo el 0,016% de los pesos del modelo.