Meta udostępnia model Muse Glimmer i zapowiada otwarcie wag dla Muse Spark 1.2
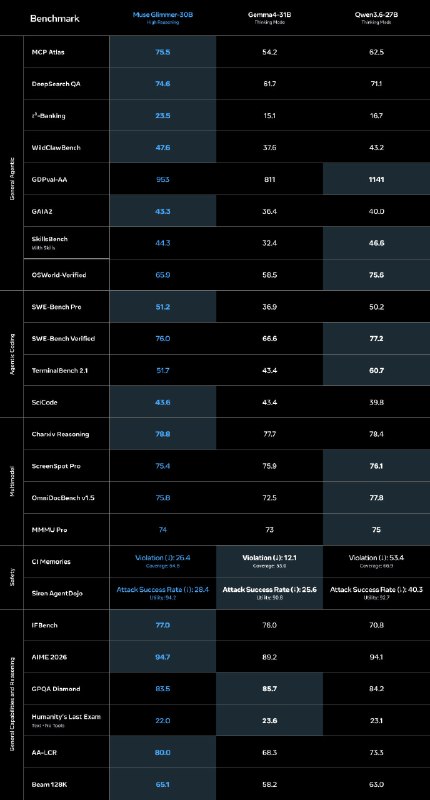
Meta prezentuje nowy multimodalny model Muse Glimmer, który przewyższa konkurencję w testach benchmarkowych. Firma ogłosiła również plany udostępnienia wag modelu Muse Spark 1.2.
Meta udostępnia model Muse Glimmer i zapowiada otwarcie wag dla Muse Spark 1.2
Muse Glimmer to 30-miliardowy model multimodalny, który w testach benchmarkowych przewyższa Qwen 3.6 27B oraz Gemma 4 31B. Jest to pierwsze znaczące wydanie otwartego dużego modelu językowego (LLM) od firmy Meta od kwietnia 2025 roku. W tej kategorii wagowej ostatnim modelem wydanym przez koncern był Code Llama 34B z sierpnia 2023 roku.
Architektonicznie jest to model gęsty (dense model) wyposażony w stosunkowo duży enkoder percepcji. Najważniejszą oczywistą wadą jest długość kontekstu wynosząca zaledwie 131k tokenów, co stanowi mniej niż u bezpośrednich konkurentów.
Wraz z modelem udostępniono oficjalne kwantyzacje, umożliwiające zmieszczenie go w 24 GB pamięci VRAM. Wydana została również oficjalna wersja modelu draft, pozwalająca na uruchomienie Muse Glimmer na pojedynczej karcie graficznej RTX 5090 z prędkością 230 tokenów na sekundę.
Dlaczego to ważne
AnalizaPremiera Muse Glimmer stanowi istotny krok naprzód w rozwoju modeli multimodalnych, mający potencjał do transformacji wielu zastosowań AI. Otwarcie wag dla Muse Spark 1.2 przyniesie dodatkowe korzyści społeczności deweloperskiej.
Dyskutuj w społeczności
Dziel się swoimi pytaniami i spostrzeżeniami z programistami
Powiązane w ekosystemie
Praktyczne poradniki, kluczowa terminologia i skille agentów
Rodzina modeli Llama (Meta Llama)
Seria fundamentalnych, otwartych modeli językowych od Meta (Llama 3, 3.1, 3.3), które stały się standardem branżowym dla ekosystemu Open Weights, lokalnej sztucznej inteligencji oraz korporacyjnego fine-tuning.
Google Gemini Pro (Model Google z ogromnym kontekstem)
Główny model roboczy od Google DeepMind z rekordowym oknem kontekstowym wynoszącym ponad 2 miliony tokenów. Zdolny do analizowania całych książek, nagrań wideo oraz dużych baz kodu w ramach jednego zapytania.
Badacze z MIT pokazali, że GPT-6 Astra może ulepszać inne modele AI przez bezpośrednią zmianę wag
W eksperymencie Astra zwiększyła dokładność Qwen3.5-0.8B w benchmarku MATH-500 z 7,9% do 48,1%, zmieniając zaledwie 0,016% wag modelu.
JSON — dane ustrukturyzowane dla aplikacji, API i agentów AI
Kompletny praktyczny przewodnik po formacie JSON: zasady składniowe, serializacja za pomocą parse/stringify, praca z REST API, JSON Schema oraz strukturalne wyjście dla sztucznej inteligencji.