Harvard uruchamia kurs bezpieczeństwa AI dla doktorantów z OpenAI i Anthropic
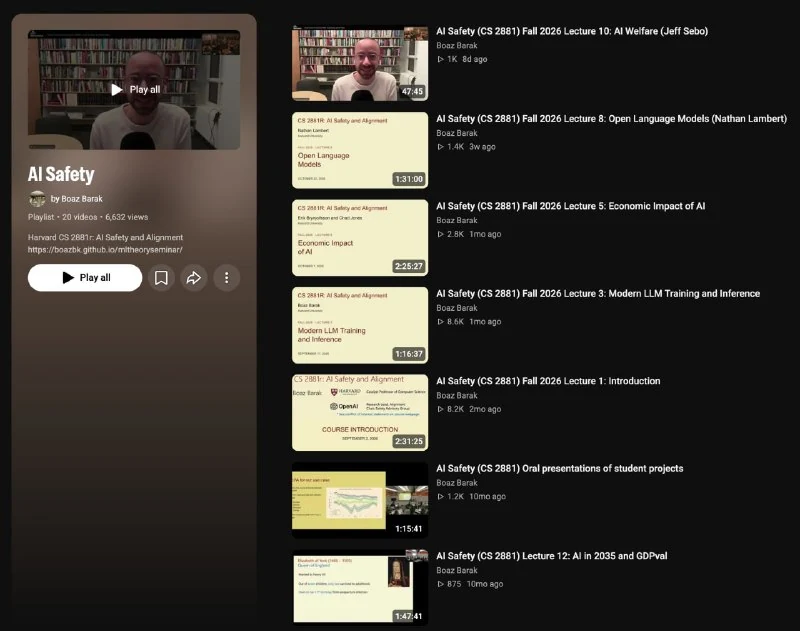
Harvard oferuje tej jesieni kurs podyplomowy dotyczący bezpieczeństwa AI, z wykładowcami z OpenAI i Anthropic oraz darmowymi wykładami na YouTube.
Harvard prowadzi tej jesieni kurs bezpieczeństwa AI dla doktorantów, a lista zaproszonych specjalistów robi wrażenie.
Z OpenAI wystąpią główny naukowiec Jakub Pachocki i współzałożyciel John Schulman, a także odbędzie się sesja pytań i odpowiedzi z Samem Altmanem.
Z Anthropic — Nicholas Carlini i Jack Lindsey.
Program obejmuje:
- RLHF i uczenie ze wzmocnieniem dla modeli zdolnych do rozumowania;
- reward hacking, gdy modele znajdują sposoby na oszukanie oceniających;
- monitorowanie śladów rozumowania;
- interpretowalność, czyli badanie wewnętrznej struktury modeli;
- cybernetyczne i biologiczne ryzyka AI;
- dopasowanie AI, gdy AI pomaga tworzyć kolejne pokolenie AI;
- specyfikacje modeli, otwarte wagi, regulacja i wpływ AI na rynek pracy.
Wykłady można oglądać za darmo na YouTube. Więcej szczegółów znajduje się w programie kursu.
Dlaczego to ważne
AnalizaKurs pokazuje, że bezpieczeństwo AI wchodzi do akademickich programów i przyciąga wiodących badaczy z laboratoriów frontier. Pomaga zrozumieć RLHF, reward hacking, interpretowalność oraz dyskusje regulacyjne wokół AI.
Dyskutuj w społeczności
Dziel się swoimi pytaniami i spostrzeżeniami z programistami
Powiązane w ekosystemie
Praktyczne poradniki, kluczowa terminologia i skille agentów
Anthropic wchodzi na giełdę: akcje notowane w okolicach $100
Anthropic pozyskała 81 mld USD w IPO i kolejne 26 mld USD w prywatnej sprzedaży akcji dużym inwestorom; popyt przekroczył podaż siedmiokrotnie.
Claude Haiku (Szybkie, kompaktowe modele Anthropic)
Najmniejszy i najszybszy model w ofercie Anthropic. Zaprojektowany do błyskawicznych odpowiedzi, masowej klasyfikacji tekstu, ekstrakcji danych oraz routingu agentowego przy minimalnych kosztach.
Claude Opus (Flagowa inteligentna modelka Anthropic)
Najsilniejszy model w rodzinie Anthropic. Stworzony do złożonej analizy filozoficznej i naukowej, tworzenia wielowarstwowych tekstów oraz głębokiego rozumienia kontekstu.
Matematyk z Anthropic twierdzi, że współpraca z Claude mogła doprowadzić do dowodu hipotezy Riemanna
Levent Alpoge twierdzi, że wspólna praca z Claude mogła doprowadzić do dowodu hipotezy Riemanna.