Google stellt multimodales Modell Gemini Decisions vor
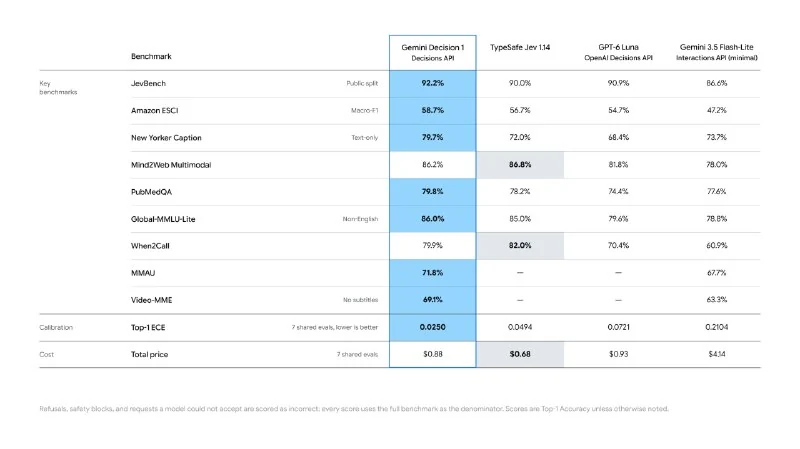
Gemini Decisions akzeptiert Video, Audio, Bilder und Text; Eingabe-Tokens kosten $0,10 pro Million.
Google hat jetzt sein eigenes Jev: Das Unternehmen stellte Gemini Decisions vor, ein multimodales Modell, das Video, Audio, Bilder und Text verarbeiten kann.
Der Preis liegt bei $0,10 pro Million Eingabe-Tokens. Das Modell kann kostenlos in AI Studio ausprobiert werden.
Warum das wichtig ist
AnalyseDas gibt Entwicklerinnen und Entwicklern einen günstigen multimodalen Einstieg für Assistenten, Medienanalyse und Automatisierung. Niedrige Eingabepreise erleichtern das Prototyping realer KI-Produkte.
In der Community diskutieren
Teile deine Fragen und Erkenntnisse mit Entwicklern
Verwandt im Ökosystem
Praktische Leitfäden, Terminologie und Agenten-Skills
Google veröffentlicht Gemini 4 Carbon
Google hat das KI-Modell Gemini 4 Carbon vorgestellt und für eine breitere Nutzerschaft verfügbar gemacht — faktisch jedoch für AI-Ultra-Abonnenten, die 250 US-Dollar zahlen.
Google stellt Gemini Decision 1 vor — KI-Modell für Entscheidungsprozesse
Google hat Gemini Decision 1 vorgestellt — ein KI-Modell für Entscheidungsprozesse über die Gemini API mit multimodaler Eingabeunterstützung.
Google Gemini Pro (Modell mit unbegrenztem Kontext)
Das Kernarbeitsmodell von Google DeepMind mit einem rekordverdächtigen Kontextfenster von über 2 Millionen Token. Es kann in einer einzigen Anfrage ganze Bücher, lange Videoaufnahmen und massive Codebases analysieren.
Gemini Flash & Pro (Google Gemini)
Eine Familie multimodaler Modelle von Google DeepMind, die ein rekordverdächtiges Kontextfenster (bis zu 2 Millionen Tokens), extreme Generierungsgeschwindigkeit (über 150 Tokens/Sekunde) und natives Verständnis für Video und Audio kombiniert.