GLM-5.3 Flash – nowy król modeli AI
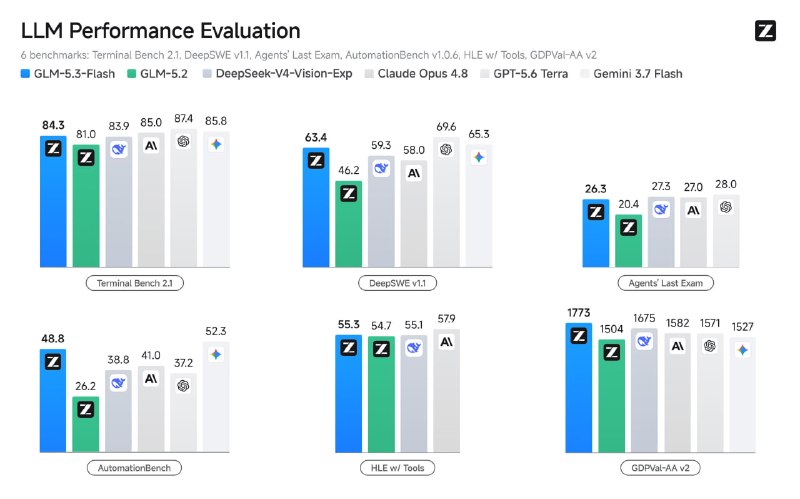
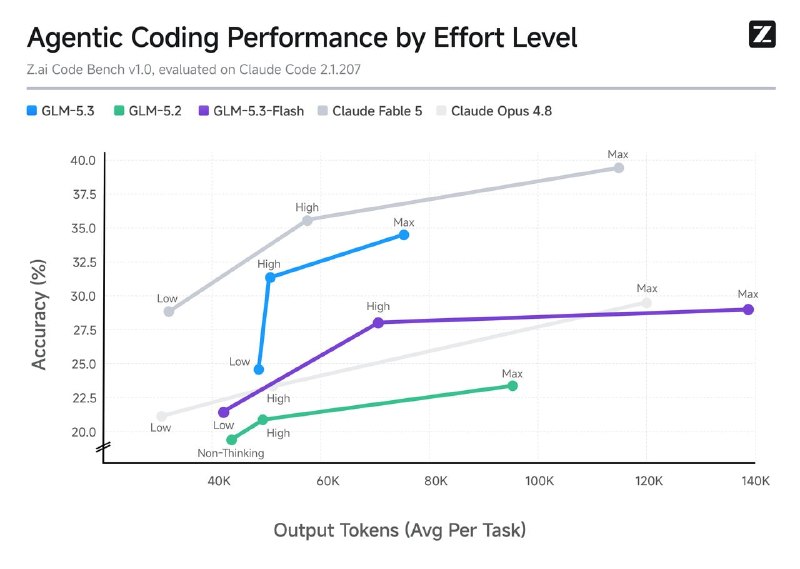
Zhipu zaprezentowało GLM-5.3 Flash, model o zwiększonej stabilności i wydajności, który zbliża się wynikami do Claude Opus 4.8 przy znacznie niższych kosztach.
Wprowadzenie GLM-5.3 Flash — nowego króla modeli AI
Firma Zhipu oficjalnie uruchomiła GLM-5.3 Flash, który stał się potężniejszy i bardziej stabilny. Według danych Z.ai, nowy model osiąga wynik 84,3 w teście Terminal-Bench 2.1, niemal dorównując Claude Opus 4.8 z wynikiem 85,0.
GLM-5.3 Flash przewyższa znacznie większy model GLM-5.2 we wszystkich sześciu opublikowanych testach, a jego użytkowanie jest około 10 razy tańsze:
- Wejście (Input) — 0,15 USD za milion tokenów.
- Wyjście (Output) — 0,50 USD.
- Wejście z pamięci podręcznej (Cached Input) — 0,03 USD.
Model cechuje się otwartymi wagami, licencją MIT, wbudowaną multimodalnością oraz kontekstem wynoszącym 1 milion tokenów.
Dlaczego to ważne
AnalizaTen model demonstruje znaczące postępy w technologii AI, oferując wysoką wydajność w przystępnej cenie. Może stać się kluczowym narzędziem dla deweloperów i badaczy w dziedzinie sztucznej inteligencji.
Dyskutuj w społeczności
Dziel się swoimi pytaniami i spostrzeżeniami z programistami
Powiązane w ekosystemie
Praktyczne poradniki, kluczowa terminologia i skille agentów
Przewodnik po promptach dla modeli generatywnych GPT Image
Modele generowania obrazów gpt-image od OpenAI zostały zaprojektowane w celu tworzenia wizualizacji o jakości produkcyjnej oraz umożliwienia pełnej kontroli nad procesami twórczymi. Są one odpowiednie zarówno dla profesjonalnych projektantów...
Claude Sonnet 4.6 vs GPT-5.5 vs Gemini 3.1 Pro: porównanie modeli na rok 2026
Co kilka tygodni pojawia się nowy model, a za każdym razem padają te same pytania: czy warto przejść? Co się zmieniło? Za co płacić?
Binance publikuje śledztwo w sprawie kradzieży 6,3 mld USD
Śledztwo wiąże kradzież ze zmodyfikowanym Homebrew, fałszywą rozmową kwalifikacyjną i wykorzystaniem wewnętrznego narzędzia AI Binance.
Użytkownik Reddita wyjaśnia, dlaczego tygodniowe limity Claude Code są wyczerpywane prawie cztery razy szybciej
Użytkownik Reddita porównał zużycie tokenów w dwóch tygodniach i stwierdził, że każdy 1% tygodniowego limitu Claude Code daje teraz znacznie mniej tokenów wyjściowych; wskazano subagentów, czas rozumowania oraz odświeżanie interfejsu jako prawdopodobne przyczyny.