Ember-1: Dostrajanie Kimi K3 skraca czas rozumowania o 40%
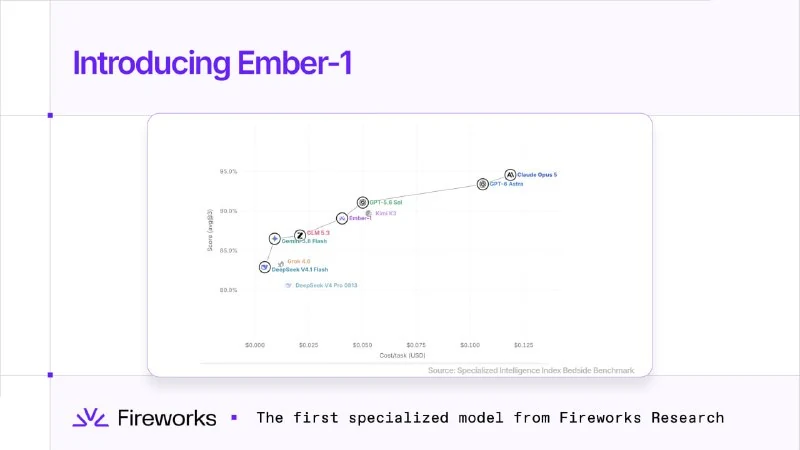
Zespół badawczy zoptymalizował model Kimi K3, redukując długość śladów rozumowania o około 40% bez utraty jakości. Ember-1 jest już dostępny w narzędziu Cline.
Ember-1 wywołuje żywe dyskusje na Hacker News.
Zespół badawczy przeprowadził dostrajanie (fine-tuning) modelu Kimi K3, dzięki czemu ślady jego rozumowania stały się o około 40% krótsze.
Jakość odpowiedzi pozostała na tym samym poziomie, a model stał się jednocześnie około 40% szybszy i tańszy w eksploatacji.
To doskonały przykład tego, jak warto budować modele językowe nowej generacji (frontier LLMs) w dzisiejszych realiach. Jeśli dysponujesz budżetem rzędu kilkudziesięciu milionów dolarów, nie musisz koniecznie trenować nowego modelu od zera. Możesz wykorzystać już istniejący, silny model i zainwestować te środki w jego precyzyjne dostrajanie.
Ember-1 jest już dostępny w ekosystemie Cline, w tym w nowej aplikacji desktopowej.
Dlaczego to ważne
AnalizaPrzypadek ten dowodzi, że modele frontier LLM można skutecznie ulepszać poprzez dostrajanie istniejących, silnych modeli zamiast kosztownego treningu od podstaw, co przekłada się na szybszą i tańszą inferencję.
Dyskutuj w społeczności
Dziel się swoimi pytaniami i spostrzeżeniami z programistami
Powiązane w ekosystemie
Praktyczne poradniki, kluczowa terminologia i skille agentów
Fine-tuning (Dostrajanie)
Proces adaptacji już wytrenowanego dużego modelu językowego do wąsko specjalistycznego zadania lub stylu przy użyciu niewielkiego, wysokiej jakości zestawu danych (Supervised Fine-Tuning, SFT). Pozwala na nauczenie AI terminologii medycznej, korporacyjnego tonu komunikacji lub formatowania specyficznego kodu w ciągu kilku godzin.
Część I. Architektura agentów AI: fundamentalne elementy
Dziesięć fundamentalnych elementów współczesnego agenta: taksonomia modeli, pętla runtime, techniki promptowania, destylacja, umiejętności (skills), pamięć, wywoływanie funkcji oraz ekonomia jednostkowa.
Część II. Architektura agentów AI: od modelu do pamięci i narzędzi
Głęboka analiza inżynierska: tokenizacja, cache KV, determinizm próbkowania, stos treningowy, kwantyzacja, inżynieria kontekstu, stos bezpieczeństwa, produkcyjny RAG, ReAct oraz systemy multiagentowe typu swarm.
RAG vs. Fine-Tuning (Wieczna dylemat wdrożeń AI)
Fundamentalny wybór architektoniczny dla biznesu. RAG (wyszukiwanie w dokumentach w czasie zapytania) kontra Fine-Tuning (zmiana wag modelu poprzez dokształcanie). Kryteria wyboru między aktualnością faktów a specyficznym stylem zachowania.