Modelos chinos abiertos muestran rastros de entrenamiento en GPUs Blackwell restringidas a la exportación
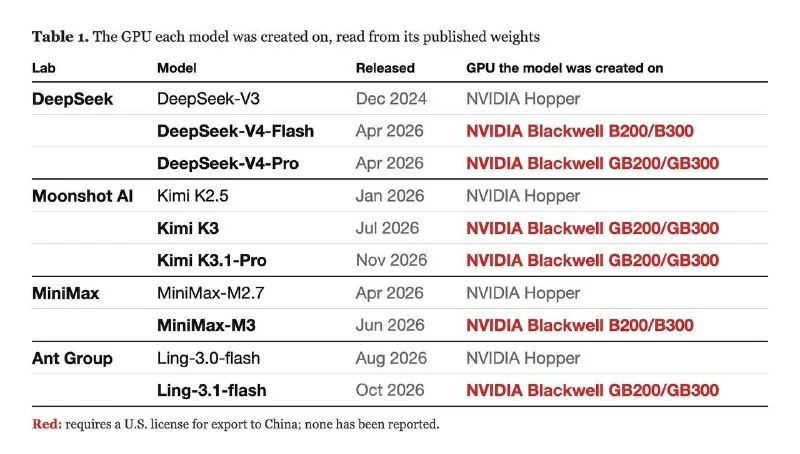
Investigadores independientes afirman haber detectado en los pesos de varios modelos chinos abiertos señales de entrenamiento con GPUs Blackwell, cuya exportación a China está restringida.
Según los investigadores, los pesos de modelos abiertos pueden conservar una «huella» de la GPU en la que se generaron por primera vez. Los valores iniciales dependen de la semilla (seed) y del chip concreto, y parte de ese patrón sobrevive al entrenamiento.
El análisis habría revisado unos seis billones de combinaciones de chips y semillas y encontró coincidencias en seis modelos de cuatro laboratorios chinos:
- DeepSeek-V4-Flash y MiniMax-M3 habrían sido entrenados con B200 o B300.
- DeepSeek-V4-Pro, Kimi K3, Kimi K3.1-Pro y Ling-3.1-flash habrían sido entrenados con GB200 o GB300.
Los modelos anteriores de esos mismos laboratorios, según la metodología, parecen haber sido entrenados con Hopper.
El autor también afirma que Kimi K3 y DeepSeek-V4-Pro podrían haber usado entre 2.000 y 3.000 GPUs Blackwell cada uno. Un clúster de esa escala cuesta unos 200 millones de dólares.
El autor dice que investigadores de OpenAI y Anthropic revisaron los resultados. Si se confirma, los laboratorios chinos podrían enfrentar sanciones graves.
Por qué es importante
AnálisisSi es correcto, el hardware de entrenamiento podría ser identificable en los pesos del modelo, lo que facilitaría vigilar el cumplimiento de las restricciones de exportación.
Debatir en la comunidad
Comparte tus preguntas e ideas con desarrolladores
Relacionado en el ecosistema
Guías prácticas, terminología y skills de agentes
Guía de prompts para los modelos generativos GPT Image
Los modelos de generación de imágenes gpt-image de OpenAI están diseñados para obtener visuales de calidad de producción y procesos creativos totalmente controlables. Son adecuados...
Claude Sonnet 4.6 vs GPT-5.5 vs Gemini 3.1 Pro: comparación de modelos 2026
Cada pocas semanas sale un nuevo modelo y cada vez surgen las mismas preguntas: ¿debería cambiar? ¿Qué cambió por qué pagar?
RLVR (Reinforcement Learning with Verifiable Rewards)
Método de post-entrenamiento y optimización del razonamiento de agentes de IA, donde la función de recompensa se basa en verificaciones matemáticas objetivas, compiladores y pruebas unitarias en lugar de evaluaciones humanas subjetivas.
KV-Cache Offloading y Compresión
Métodos hardware y algorítmicos para la descarga temporal de la caché de claves y valores (KV-Cache) desde la costosa memoria de video GPU a la memoria RAM del sistema o a rápidos SSD NVMe.