Бенчмарки, когда наняли зумера на роль Chief AI Officer
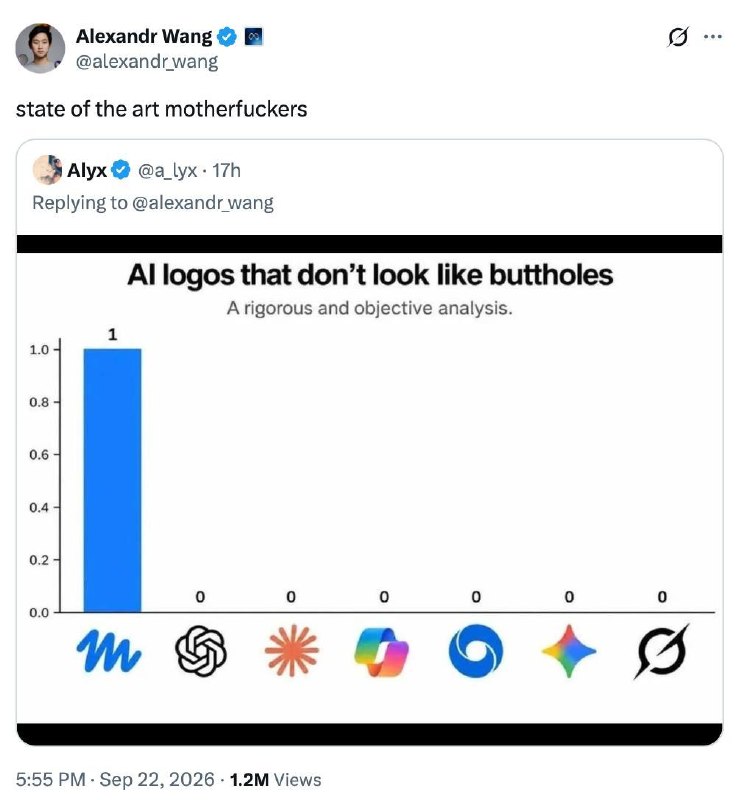
Реакция на назначение молодых специалистов на роль Chief AI Officer и влияние на бенчмарки.
Бенчмарки, когда наняли зумера на роль Chief AI Officer.
Этот заголовок иллюстрирует новый тренд в корпоративной среде: привлечение представителей поколения Z к руководящим должностям в сфере искусственного интеллекта. Изменение подхода к найму AI-лидеров может существенно влиять на то, как компания оценивает эффективность своих моделей и стратегий внедрения ИИ.
Почему это важно
АналитикаПоказывает смену парадигмы найма в IT и влияние поколенческих особенностей на управление AI-проектами.
Обсудить в сообществе
Делитесь опытом и мыслями с ИИ-разработчиками
Связанные материалы экосистемы
Практические гайды, терминология и агентские скиллы
Claude Fable 5: когда использовать мощную модель и какой уровень effort выбрать
Полный разбор модели Claude Fable 5 и параметра effort: поведенческий сигнал рассуждений, матрица доступности уровней (low/xhigh), расчет затрат на ход и практическая настройка в API и Claude Code.
Форматы DOCX и XLSX: когда от ИИ требуется полноценный финальный документ
Практическое руководство по созданию и обработке документов DOCX и таблиц XLSX с помощью ИИ: сравнение с Markdown и CSV, промпт-инжиниринг, работа с формулами и автоматизация в коде.
Бенчмарки для агентов: GAIA и SWE-bench
Новое поколение строгих практических бенчмарков для оценки автономности искусственного интеллекта. GAIA тестирует мультимодальные задачи в открытом вебе с файлами и браузером, а SWE-bench проверяет способность агентов находить и исправлять настоящие баги в больших репозиториях GitHub.
Оценка Агентов и Бенчмаркинг SWE-bench
Методология и инфраструктура систематического измерения надежности, точности и безопасности ИИ-агентов с помощью синтетических тестов, SWE-bench и headless репозиторных симуляций.