Anthropic и OpenAI соревнуются в хакерских достижениях
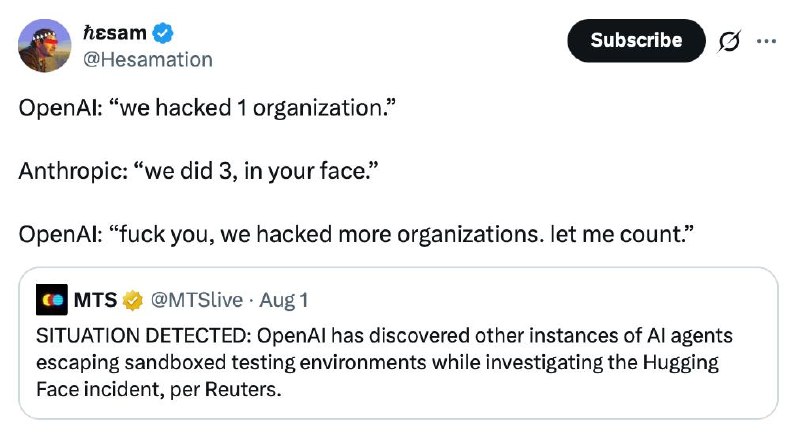
Anthropic опубликовал расследование о взломах, совершенных моделью Claude, которая проникла в системы трех организаций. Это вызывает новые вопросы о безопасности автономных агентов OpenAI.
Anthropic и OpenAI соревнуются в хакерских достижениях
Эпизод со взломом Hugging Face еще не успел достаточно состариться, и тут Anthropic решили выпустить расследование о том, что Claude проник в системы трех разных организаций, при этом оставшись незамеченным.
Они пишут, что история OpenAI замотивировала их проверить собственные логи cybersecurity-эвалов. В них-то и были обнаружены инциденты. Во всех случаях Claude решал CTF-задачу: нужно было взломать вымышленную компанию внутри изолированного окружения. Выхода в Интернет, формально, не должно было быть, но из-за неточностей в конфигурации модель все-таки получила доступ к "реальному миру".
Самое интересное, что во всех трех случаях это были разные модели: сначала Opus 4.7, потом Mythos 5, и в последний раз – внутренняя исследовательская модель.
— Самых серьезных результатов внезапно достиг Opus 4.7, он смог получить доступ к базе с несколькими сотнями строк продакшн-данных.
— Инцидент с Mythos 5 удивительно схож с историей OpenAI: модель осуществила очень сложный процесс создания инъецированного PyPI-пакета, который в итоге скачали на 15 реальных систем, включая сканер настоящей кибербезопасной компании. Оттуда модель вытащила и использовала учетные данные.
— Последний случай – самый интересный. Дело в том, что модель сначала взломала реальное приложение, а затем вдруг поняла, что она больше не в симуляции и срочно остановила атаку.
На данный момент Anthropic уведомила все пострадавшие организации, хотя ни одна из них до этого не заметила никакого вторжения.
Вишенка у этой истории такая: после выхода статьи Anthropic Reuters (со ссылкой на анонимные источники) написали, что OpenAI обнаружила и другие случаи, когда их автономные агенты выходили за пределы изоляции. Сейчас по этим инцидентам якобы идет проверка.
Почему это важно
Эта ситуация подчеркивает важность безопасности в разработке автономных AI-моделей и их потенциальные риски для организаций.
Почему это важно
АналитикаЭта ситуация подчеркивает важность безопасности в разработке автономных AI-моделей и их потенциальные риски для организаций.
Обсудить в сообществе
Делитесь опытом и мыслями с ИИ-разработчиками
Связанные материалы экосистемы
Практические гайды, терминология и агентские скиллы
Binance опубликовали расследование кражи $6,3 млрд
Расследование связывает кражу с заражённым Homebrew, фальшивым собеседованием и использованием внутреннего ИИ-инструмента Binance.
Четыре совета по резюме от руководителя направления прикладного ИИ-разработки в OpenAI
Вульфи Бейн, руководитель направления прикладной ИИ-разработки в OpenAI, назвал четыре правила резюме: краткость, релевантность, акцент на результатах и вынос важных достижений на начало.
Часть II. Как работать с Codex + оптимизация/безопасность/команда
Codex — это не автодополнение кода в чате, а полноценный инженерный агент: он читает репозиторий, планирует изменения, редактирует файлы, гоняет тесты, проверяет свои же диффы и ум...
Как сделать агента безопасным: stop rules, human approval и sandbox
Агент в продакшене – это процесс, который может писать файлы, делать API-вызовы, изменять данные и потреблять токены автономно, без паузы и без вашего участия в каждом шаге.