Anthropic elige a Accenture como 'evaluador independiente' de seguridad de IA, financiando sus propias auditorías
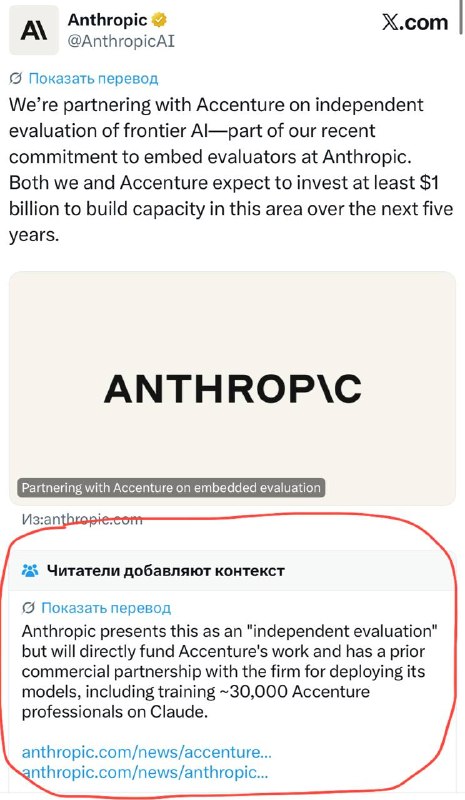
Anthropic ha presentado a Accenture como un evaluador independiente de la seguridad de sus modelos, a pesar de que la empresa es financiada por Anthropic y mantiene contratos a largo plazo con la compañía.
Anthropic elige a Accenture como 'evaluador independiente' de seguridad de IA, financiando sus propias auditorías
Anthropic ha anunciado el primer "evaluador independiente" bajo su programa Embedded Evaluators, un concepto promovido previamente por Dario Amodei en su ensayo sobre la ralentización del desarrollo de la IA.
La empresa elegida es Accenture. Su mandato incluye realizar:
- Ejercicios de red-teaming (búsqueda de vulnerabilidades);
- Verificaciones de alineación (alignment);
- Pruebas de salvaguardas (safeguards) para los modelos Claude.
Sin embargo, el estatus de "independencia" de Accenture plantea serias dudas:
- Accenture capacita a aproximadamente 30.000 de sus empleados en el uso de Claude.
- Las dos empresas tienen un contrato plurianual que data de finales de 2025.
- Lo más crítico: Anthropic declara explícitamente que financiará el trabajo de Accenture en esta capacidad.
Esto refleja una situación anterior con METR, que recibió "acceso independiente" de Anthropic para investigar incidentes con agentes, a pesar de que METR también está indirectamente financiado a través de las acciones de la startup.
En esencia: Anthropic afirma traer evaluadores independientes, pero los selecciona de un grupo de socios comerciales que ella misma financia.
Por qué es importante
AnálisisEsta situación socava la confianza en las auditorías de seguridad de la IA, ya que los revisores "independientes" dependen financieramente de las empresas cuyos modelos están evaluando, creando un claro conflicto de intereses.
Debatir en la comunidad
Comparte tus preguntas e ideas con desarrolladores
Relacionado en el ecosistema
Guías prácticas, terminología y skills de agentes
Problema de Alineación de IA (AI Alignment)
Problema fundamental de seguridad de la inteligencia artificial: alinear los objetivos y motivaciones de sistemas autónomos con los valores humanos, la ética y la preservación de la vida. Explora los riesgos de que un sistema superinteligente encuentre una forma literal o destructiva de cumplir una tarea vagamente definida.
Claude rechazó una tarea por la palabra “cyber”
Una breve observación de que Claude se negó a ejecutar una tarea por la palabra “cyber”.
Claude Haiku (Modelos Compactos Rápidos de Anthropic)
El modelo más compacto y rápido de la línea de Anthropic. Diseñado para respuestas instantáneas, clasificación masiva de textos, extracción de datos y enrutamiento agente a un costo mínimo.
Servicio que evalúa el riesgo de bloqueo por parte de Anthropic
Desarrolladores chinos lanzaron un servicio que analiza la dirección IP, el país, el proveedor, el tipo de conexión y las filtraciones de DNS y WebRTC para puntuar la confianza de 0 a 100 frente a Anthropic.