З’явився новий бенчмарк
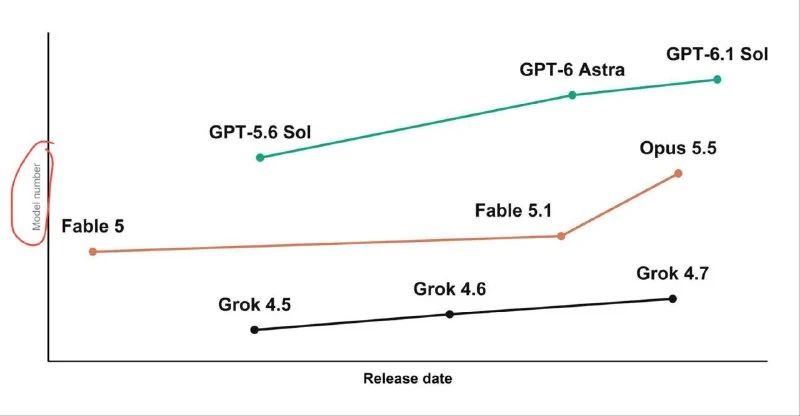
Новий бенчмарк з’явився без оприлюднених деталей.
У публікації немає посилання на репозиторій, статтю, модель чи метрики, тому оцінити його актуальність і надійність поки неможливо.
Чому це важливо
АналітикаБенчмарки допомагають оцінювати прогрес ШІ, але без джерела та метрик не можна робити висновки про якість тесту.
Обговорити новину у спільноті
Діліться своїм досвідом та думками з ШІ-розробниками
Пов'язані матеріали екосистеми
Практичні гайди, термінологія та агентські скіли
Claude Sonnet 4.6 vs GPT-5.5 vs Gemini 3.1 Pro: порівняння моделей 2026
Кожні кілька тижнів виходить нова модель, і щоразу ті самі запитання: чи варто переходити? що змінилося? за що платити?
GPT-6.2 Astra: приклади 3D-генерації в ШІ-моделі
Модель GPT-6.2 Astra демонструє створення 3D-сцен, включно з відтворенням Vice City та Ріка Астлі, але складні запити можуть швидко вичерпувати ліміти підписки.
Бенчмарки для агентів: GAIA та SWE-bench
Нове покоління суворих практичних бенчмарків для оцінки автономності штучного інтелекту. GAIA тестує мультимодальні завдання у відкритому вебі з файлами та браузером, а SWE-bench перевіряє здатність агентів знаходити та виправляти справжні баги у великих репозиторіях GitHub.
Забруднення бенчмарків (Data Contamination)
Проблема об'єктивності оцінки штучного інтелекту, коли запитання та відповіді зі стандартних тестових наборів (MMLU, HumanEval, GSM8K) випадково або навмисно потрапляють у тренувальні дані моделі, призводячи до штучно завищених оцінок на презентаціях.