Kimi K3.1 und DeepSeek V4.1 Flash Berichten zufolge aus Astra destilliert
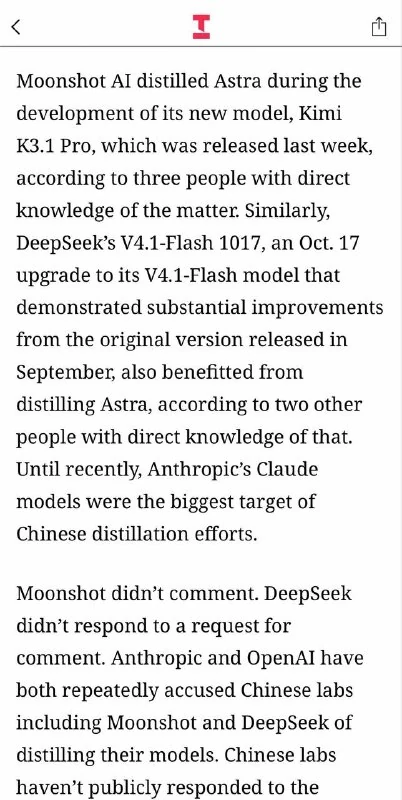
The Information berichtet, dass Kimi K3.1 und DeepSeek V4.1 Flash möglicherweise durch Distillation von Astra erzeugt wurden, einem Modell im Umfeld von OpenAI.
The Information berichtet, dass Kimi K3.1, ein neu veröffentlichtes chinesisches Modell, offenbar aus Astra destilliert wurde — einem Modell im Umfeld von OpenAI.
Derselbe Bericht behauptet, ein ähnlicher Ansatz könnte auch für den neuen Checkpoint DeepSeek V4.1 Flash verwendet worden sein.
Warum das wichtig ist
- Bei der Distillation wird ein kleineres Modell anhand der Ausgaben oder versteckten Zustände eines größeren Modells trainiert.
- Falls sich die Angaben bestätigen, könnte Astra eine wichtige Wissensquelle für chinesische KI-Labore sein.
- Der Fall zeigt, wie Capability-Transfer zwischen großen KI-Ökosystemen den Wettbewerb verändern kann.
Warum das wichtig ist
AnalyseFalls sich die Angaben bestätigen, zeigt der Fall, wie Distillation den Kompetenzaustausch zwischen führenden KI-Ökosystemen beschleunigt und Fragen zur Herkunft von Modellen verschärft.
In der Community diskutieren
Teile deine Fragen und Erkenntnisse mit Entwicklern
Verwandt im Ökosystem
Praktische Leitfäden, Terminologie und Agenten-Skills
DeepSeek V4.1 Flash jetzt in Cursor verfügbar
DeepSeek V4.1 Flash ist jetzt in Cursor verfügbar; laut CursorBench-Ergebnissen kostet eine Aufgabe 0,60–0,98 US-Dollar, was das Modell für die tägliche Arbeit mit Code attraktiv macht.
DeepSeek (Chinesischer Durchbruch im Bereich Open-Source-KI)
Eine Reihe bahnbrechender Open-Source-Modelle des chinesischen Labors DeepSeek (V3, R1). Sie demonstriert das höchste Niveau in Coding und Reasoning bei Kosten, die 10–20 Mal niedriger sind als bei westlichen kommerziellen Alternativen.
Lokale LLMs ausführen: Einrichtung, Modelle und Optimierung
Ein umfassender Leitfaden zur Ausführung lokaler neuronaler Netze auf dem eigenen PC: Hardwareanforderungen, Bereitstellung von Ollama und Open WebUI, Überblick über Llama 3, Qwen 2.5, DeepSeek sowie GGUF-Quantisierung.
RLVR (Reinforcement Learning with Verifiable Rewards)
Eine Methode zur Nachbereitung und Optimierung des Reasonings von KI-Agenten, bei der die Belohnungsfunktion auf objektiven mathematischen Überprüfungen, Compilern und Unit-Tests basiert, anstatt auf subjektiven menschlichen Bewertungen.