У відкритих китайських ШІ-моделях нібито виявили сліди навчання на GPU Blackwell, заборонених для експорту до КНР
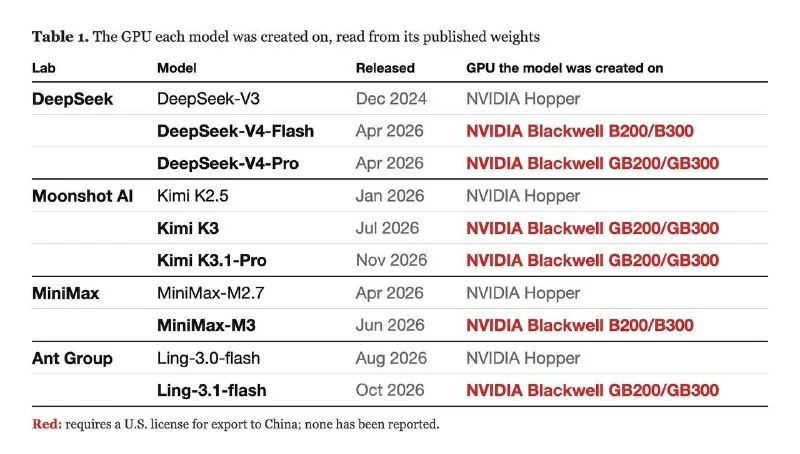
За попередніми даними, у вагах відкритих китайських моделей нібито знайшли сліди навчання на GPU Blackwell, експорт яких до КНР обмежений.
За заявою незалежних дослідників, у вагах відкритих моделей може залишатися «відбиток» GPU, на якому ці ваги вперше згенерували. Початкові значення ваг залежать від seed і конкретного чипа, і частина цього візерунка переживає навчання.
Аналіз близько шести трильйонів комбінацій чипів і seed нібито дав збіги у шести моделях чотирьох китайських лабораторій:
- DeepSeek-V4-Flash і MiniMax-M3 — на B200 або B300;
- DeepSeek-V4-Pro, Kimi K3, Kimi K3.1-Pro та Ling-3.1-flash — на GB200 або GB300.
За цією методикою раніші моделі тих самих лабораторій виглядають як навчені на Hopper.
Автор також стверджує, що для Kimi K3 і DeepSeek-V4-Pro могло бути використано від 2 тис. до 3 тис. Blackwell GPU на кожну модель. Кластер такого масштабу коштує приблизно $200 млн.
Якщо твердження підтвердяться, китайським лабораторіям можуть загрожувати серйозні санкції.
Чому це важливо
АналітикаЦе важливо, бо технічна перевірка апаратного забезпечення ШІ-моделей може ускладнити обхід експортних обмежень і посилити санкційний тиск на розробників.
Обговорити новину у спільноті
Діліться своїм досвідом та думками з ШІ-розробниками
Пов'язані матеріали екосистеми
Практичні гайди, термінологія та агентські скіли
У мережі з’явилася жартівлива заява про нібито проходження тесту на загальний ШІ моделлю Claude Fable 5.2
У мережі поширюється жартівливе повідомлення про нібито успішне проходження тесту на загальний ШІ (AGI) моделлю Claude Fable 5.2.
Промпт-гайд по генеративним моделям GPT Image
Моделі генерації зображень gpt-image від OpenAI створені для отримання візуалів виробничої якості та повністю керованих творчих процесів. Вони підходять як для професійних дизайн-з...
Claude Sonnet 4.6 vs GPT-5.5 vs Gemini 3.1 Pro: порівняння моделей 2026
Кожні кілька тижнів виходить нова модель, і щоразу ті самі запитання: чи варто переходити? що змінилося? за що платити?
RLVR (Reinforcement Learning with Verifiable Rewards)
Метод пост-тренінгу та оптимізації міркувань ШІ-агентів, де функція винагороди базується на об'єктивних математичних перевірках, компіляторах та юніт-тестах замість суб'єктивних людських оцінок.