Графік змагання США та Китаю в AI
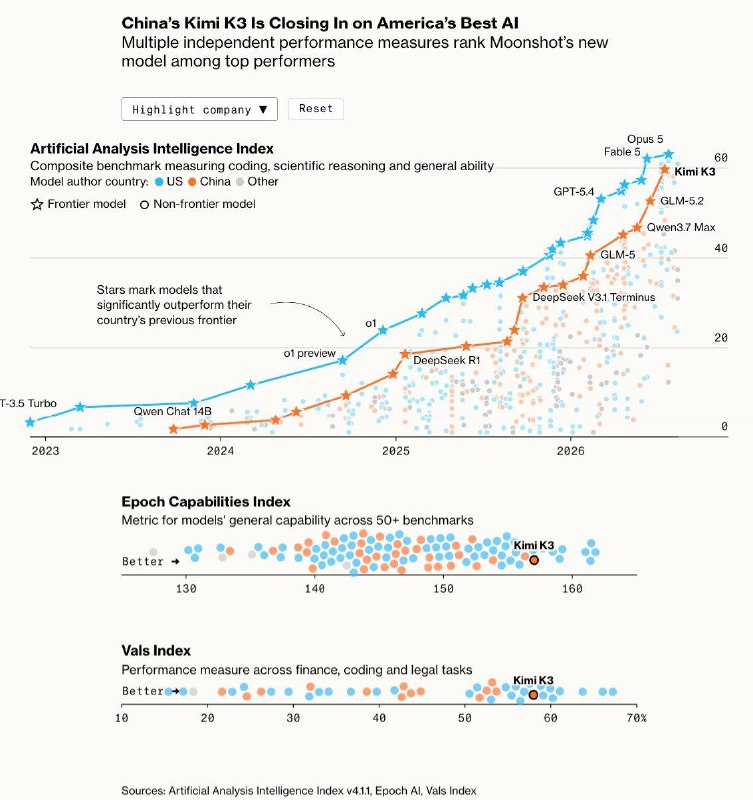
Графік показує, як за кілька років скоротився розрив у можливостях між китайськими та американськими моделями штучного інтелекту.
Дуже показовий графік з свіжої статті Bloomberg.
Оранжеві точки – китайські моделі, сині – США. По осі Y – взважене середнє по бенчмаркам GDPval-AA v2, τ³-Banking, Terminal-Bench v2.1, Humanity’s Last Exam, GPQA Diamond, CritPt, SciCode, AA-Omniscience та AA-LCR.
Ломаною з'єднані фронтирні моделі. Видно, наскільки за пару років скоротився розрив у здібностях (і це ще на графіку немає GLM-5.3). Багато американських лідерів досі стверджують, що китайські моделі відстають на 6-9 місяців, але, очевидно, ця інформація застаріла. І це вже не кажучи про ціни.
Чому це важливо
АналітикаЦей графік ілюструє швидкий прогрес китайських моделей штучного інтелекту, що може вплинути на глобальну конкурентоспроможність у технологічній сфері.
Обговорити новину у спільноті
Діліться своїм досвідом та думками з ШІ-розробниками
Пов'язані матеріали екосистеми
Практичні гайди, термінологія та агентські скіли
Промпт-гайд по генеративним моделям GPT Image
Моделі генерації зображень gpt-image від OpenAI створені для отримання візуалів виробничої якості та повністю керованих творчих процесів. Вони підходять як для професійних дизайн-з...
Claude Sonnet 4.6 vs GPT-5.5 vs Gemini 3.1 Pro: порівняння моделей 2026
Кожні кілька тижнів виходить нова модель, і щоразу ті самі запитання: чи варто переходити? що змінилося? за що платити?
Binance оприлюднили розслідування крадіжки $6,3 млрд
Розслідування пов’язує масштабну крадіжку з модифікованим Homebrew, фальшивою співбесідою та використанням внутрішнього ШІ-інструменту Binance.
Користувач Reddit з’ясував, чому тижневі ліміти Claude Code витрачаються майже вчетверо швидше
Користувач Reddit порівняв використання токенів за два тижні та виявив, що на кожен 1% тижневого ліміту Claude Code тепер припадає значно менше вихідних токенів, а основними підозрюваними стали субагенти, тривалість міркувань і фонові запити інтерфейсу.