Ілон Маск обіцяє зробити X повністю опенсорсним
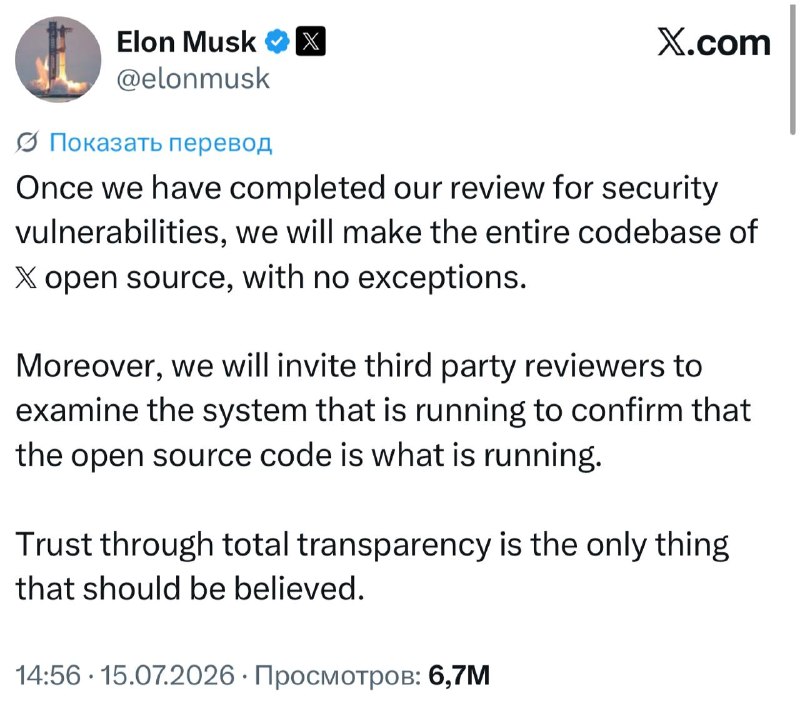
Ілон Маск оголосив про намір зробити платформу X повністю опенсорсною, що забезпечить прозорість і довіру до системи.
Ілон Маск обіцяє зробити X повністю опенсорсним
Ілон Маск нещодавно оголосив, що планує зробити платформу X повністю опенсорсною. Це означає, що не йдеться лише про окремі алгоритми чи рекомендаційні системи, а про відкриття всього коду платформи.
Крім того, Маск зазначив, що будуть запрошені незалежні експерти для перевірки системи, яка наразі працює, щоб підтвердити, що відкритий вихідний код відповідає тому, що дійсно запущено. "Довіра через повну прозорість – це єдине, чому варто вірити", – підкреслив він.
Чому це важливо
АналітикаЦе важливо, оскільки відкриття коду може підвищити довіру користувачів до платформи та забезпечити більшу прозорість у її функціонуванні.
Обговорити новину у спільноті
Діліться своїм досвідом та думками з ШІ-розробниками
Пов'язані матеріали екосистеми
Практичні гайди, термінологія та агентські скіли
Як створити власну дизайн-систему в Claude Design: від мудборду до анімованого маскота
Повний практичний посібник зі створення дизайн-системи бренду в Claude Design: збір візуальних референсів, генерація 4 концепцій, токенізація, стрес-тестування та розробка анімованого SVG-маскота.
Як зробити агента безпечним: stop rules, human approval і sandbox
Агент у продакшені — це процес, який може писати файли, робити API-виклики, змінювати дані та споживати токени автономно, без паузи і без вашої участі в кожному кроці.
Agent-to-Agent Protocol (A2A)
Відкритий стандарт мережевої взаємодії, децентралізованого виявлення та безпечного обміну контекстом між незалежними ШІ-агентами різних вендорів і платформ.
Бенчмарки для агентів: GAIA та SWE-bench
Нове покоління суворих практичних бенчмарків для оцінки автономності штучного інтелекту. GAIA тестує мультимодальні завдання у відкритому вебі з файлами та браузером, а SWE-bench перевіряє здатність агентів знаходити та виправляти справжні баги у великих репозиторіях GitHub.