ByteDance навчає модель з 10 трлн параметрів
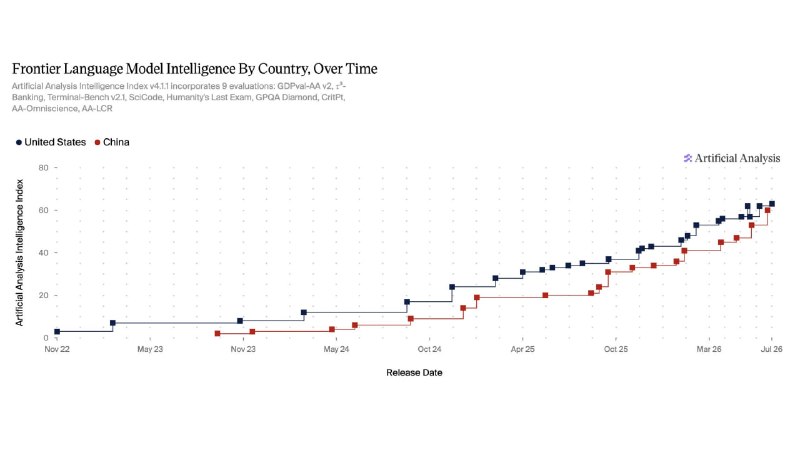
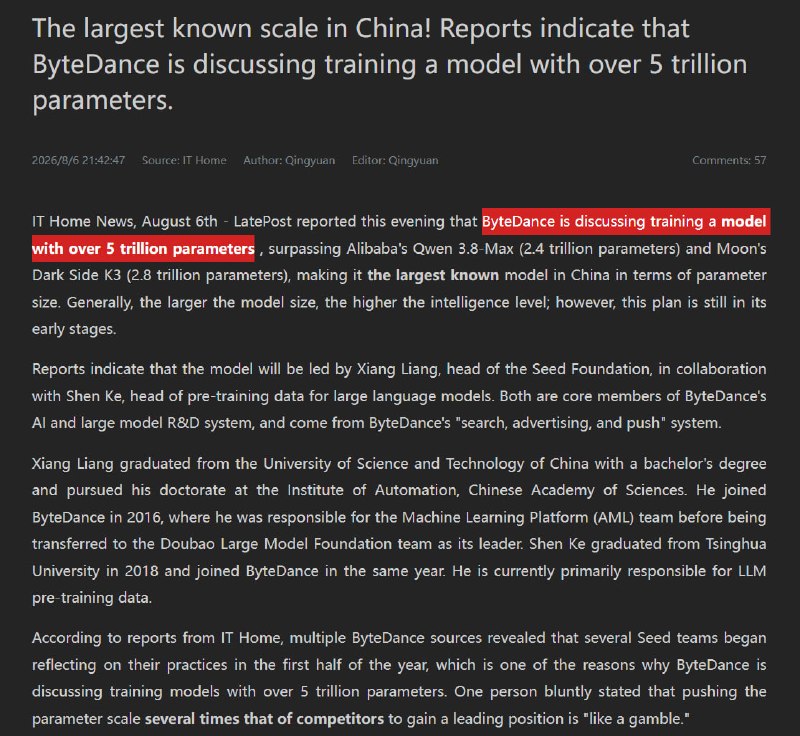
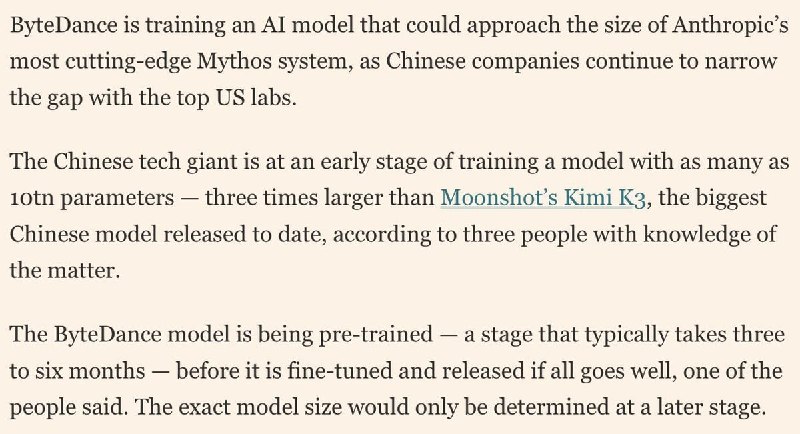
ByteDance навчає нову модель з 10 трлн параметрів, що перевищує Kimi K3 втричі. Це підкреслює зростаючу конкуренцію між американськими та китайськими AI-лабораторіями.
ByteDance навчає модель з 10 трлн параметрів
ByteDance, згідно з даними кількох джерел, навчає модель розміром до 10 трлн параметрів — приблизно в три рази більше Kimi K3.
На цьому фоні все складніше уявити сценарій, в якому американські лабораторії просто вирішать сповільнитися. Поки Китай продовжує інвестувати, масштабувати і давити на газ, така пауза буде означати ризик віддати лідерство конкуренту.
Чому це важливо
АналітикаЦе важливо, оскільки підкреслює зростаючу конкуренцію в сфері штучного інтелекту між США та Китаєм, що може вплинути на глобальні технологічні тренди.
Обговорити новину у спільноті
Діліться своїм досвідом та думками з ШІ-розробниками
Пов'язані матеріали екосистеми
Практичні гайди, термінологія та агентські скіли
JSON — структуровані дані для програм, API та AI-агентів
Повний практичний посібник з формату JSON: синтаксичні правила, серіалізація через parse/stringify, робота з REST API, JSON Schema та структурований вивід для штучного інтелекту.
Формати DOCX та XLSX: коли потрібен повноцінний фінальний документ від ШІ
Повний практичний посібник з генерації та опрацювання документів DOCX і таблиць XLSX за допомогою ШІ: порівняння з Markdown та CSV, промпт-інжиніринг, робота з формулами та автоматизація в коді.
Binance оприлюднили розслідування крадіжки $6,3 млрд
Розслідування пов’язує масштабну крадіжку з модифікованим Homebrew, фальшивою співбесідою та використанням внутрішнього ШІ-інструменту Binance.
Користувач Reddit з’ясував, чому тижневі ліміти Claude Code витрачаються майже вчетверо швидше
Користувач Reddit порівняв використання токенів за два тижні та виявив, що на кожен 1% тижневого ліміту Claude Code тепер припадає значно менше вихідних токенів, а основними підозрюваними стали субагенти, тривалість міркувань і фонові запити інтерфейсу.